Train a CIFAR-10 model
This page includes the notebook’s saved outputs. It does not run training in your browser.
Train a CIFAR-10 Model
Section titled “Train a CIFAR-10 Model”This guide demonstrates how to train a CIFAR-10 model using HeliaEdge. Install helia-edge[tensorflow,plotting] to include the training and visualization dependencies.
import os
import kerasimport matplotlib.pyplot as pltimport numpy as npimport tensorflow as tf
import helia_edge as helia
Saved output
2024-08-29 18:22:27.004701: I tensorflow/core/util/port.cc:153] oneDNN custom operations are on. You may see slightly different numerical results due to floating-point round-off errors from different computation orders. To turn them off, set the environment variable `TF_ENABLE_ONEDNN_OPTS=0`.2024-08-29 18:22:27.011355: E external/local_xla/xla/stream_executor/cuda/cuda_fft.cc:485] Unable to register cuFFT factory: Attempting to register factory for plugin cuFFT when one has already been registered2024-08-29 18:22:27.019207: E external/local_xla/xla/stream_executor/cuda/cuda_dnn.cc:8454] Unable to register cuDNN factory: Attempting to register factory for plugin cuDNN when one has already been registered2024-08-29 18:22:27.021477: E external/local_xla/xla/stream_executor/cuda/cuda_blas.cc:1452] Unable to register cuBLAS factory: Attempting to register factory for plugin cuBLAS when one has already been registered2024-08-29 18:22:27.027787: I tensorflow/core/platform/cpu_feature_guard.cc:210] This TensorFlow binary is optimized to use available CPU instructions in performance-critical operations.To enable the following instructions: AVX2 AVX_VNNI FMA, in other operations, rebuild TensorFlow with the appropriate compiler flags.2024-08-29 18:22:27.419630: W tensorflow/compiler/tf2tensorrt/utils/py_utils.cc:38] TF-TRT Warning: Could not find TensorRT# ConstantsAUG_SIZE = 64CROP_SIZE = 48NUM_CLASSES = 10SHUFFLE_SIZE = 10000BATCH_SIZE = 256EPOCHS = 50LR_RATE = 1e-3LR_CYCLES = 1VERBOSE = 1(x_train, y_train), (x_test, y_test) = keras.datasets.cifar10.load_data()y_train = y_train.squeeze()y_test = y_test.squeeze()y_train[:15]Saved output
array([6, 9, 9, 4, 1, 1, 2, 7, 8, 3, 4, 7, 7, 2, 9], dtype=uint8)train_ds = tf.data.Dataset.from_tensor_slices((x_train, y_train))val_ds = tf.data.Dataset.from_tensor_slices((x_test, y_test))Saved output
WARNING: All log messages before absl::InitializeLog() is called are written to STDERRI0000 00:00:1724955748.587058 209138 cuda_executor.cc:1015] successful NUMA node read from SysFS had negative value (-1), but there must be at least one NUMA node, so returning NUMA node zero. See more at https://github.com/torvalds/linux/blob/v6.0/Documentation/ABI/testing/sysfs-bus-pci#L344-L355I0000 00:00:1724955748.606303 209138 cuda_executor.cc:1015] successful NUMA node read from SysFS had negative value (-1), but there must be at least one NUMA node, so returning NUMA node zero. See more at https://github.com/torvalds/linux/blob/v6.0/Documentation/ABI/testing/sysfs-bus-pci#L344-L355I0000 00:00:1724955748.606421 209138 cuda_executor.cc:1015] successful NUMA node read from SysFS had negative value (-1), but there must be at least one NUMA node, so returning NUMA node zero. See more at https://github.com/torvalds/linux/blob/v6.0/Documentation/ABI/testing/sysfs-bus-pci#L344-L355I0000 00:00:1724955748.607778 209138 cuda_executor.cc:1015] successful NUMA node read from SysFS had negative value (-1), but there must be at least one NUMA node, so returning NUMA node zero. See more at https://github.com/torvalds/linux/blob/v6.0/Documentation/ABI/testing/sysfs-bus-pci#L344-L355I0000 00:00:1724955748.607872 209138 cuda_executor.cc:1015] successful NUMA node read from SysFS had negative value (-1), but there must be at least one NUMA node, so returning NUMA node zero. See more at https://github.com/torvalds/linux/blob/v6.0/Documentation/ABI/testing/sysfs-bus-pci#L344-L355I0000 00:00:1724955748.607917 209138 cuda_executor.cc:1015] successful NUMA node read from SysFS had negative value (-1), but there must be at least one NUMA node, so returning NUMA node zero. See more at https://github.com/torvalds/linux/blob/v6.0/Documentation/ABI/testing/sysfs-bus-pci#L344-L355I0000 00:00:1724955748.648330 209138 cuda_executor.cc:1015] successful NUMA node read from SysFS had negative value (-1), but there must be at least one NUMA node, so returning NUMA node zero. See more at https://github.com/torvalds/linux/blob/v6.0/Documentation/ABI/testing/sysfs-bus-pci#L344-L355I0000 00:00:1724955748.648420 209138 cuda_executor.cc:1015] successful NUMA node read from SysFS had negative value (-1), but there must be at least one NUMA node, so returning NUMA node zero. See more at https://github.com/torvalds/linux/blob/v6.0/Documentation/ABI/testing/sysfs-bus-pci#L344-L3552024-08-29 18:22:28.648458: W tensorflow/core/common_runtime/gpu/gpu_bfc_allocator.cc:47] Overriding orig_value setting because the TF_FORCE_GPU_ALLOW_GROWTH environment variable is set. Original config value was 0.I0000 00:00:1724955748.648484 209138 cuda_executor.cc:1015] successful NUMA node read from SysFS had negative value (-1), but there must be at least one NUMA node, so returning NUMA node zero. See more at https://github.com/torvalds/linux/blob/v6.0/Documentation/ABI/testing/sysfs-bus-pci#L344-L3552024-08-29 18:22:28.648530: I tensorflow/core/common_runtime/gpu/gpu_device.cc:2021] Created device /job:localhost/replica:0/task:0/device:GPU:0 with 21858 MB memory: -> device: 0, name: NVIDIA GeForce RTX 4090, pci bus id: 0000:01:00.0, compute capability: 8.9# # Plot a random imagefig, ax = plt.subplots(figsize=(2, 2))ax.imshow(x_train[np.random.randint(0, x_train.shape[0])])_ = ax.axis("off")Saved output
augmenter = helia.layers.preprocessing.AugmentationPipeline( layers=[ helia.layers.preprocessing.Resizing2D(height=AUG_SIZE, width=AUG_SIZE, name="Resizing"), helia.layers.preprocessing.RandomFlip2D(horizontal=True, vertical=False, name="RandomFlip"), helia.layers.preprocessing.RandomCrop2D( height=CROP_SIZE, width=CROP_SIZE, name="RandomCrop", auto_vectorize=True ), helia.layers.preprocessing.LayerNormalization2D(name="normalize"), ],)y = augmenter(x_train[:1].astype(np.float32))# # Plot a random imagefig, ax = plt.subplots(figsize=(2, 2))ax.imshow(y[0].numpy(), vmin=-2.6, vmax=4)_ = ax.axis("off")Saved output
[08/29/24 18:22:28] WARNING WARNING:matplotlib.image:Clipping input data to the valid range for ]8;id=450190;file:///workspaces/helia-edge/.venv/lib/python3.11/site-packages/matplotlib/image.py\image.py]8;;\:]8;id=197316;file:///workspaces/helia-edge/.venv/lib/python3.11/site-packages/matplotlib/image.py#705\705]8;;\ imshow with RGB data ([0..1] for floats or [0..255] for integers). Got range [-2.9038177..3.3586729].
train_ds = ( train_ds.shuffle(buffer_size=SHUFFLE_SIZE) .batch(batch_size=BATCH_SIZE) .map( lambda data, labels: { "data": tf.cast(data, "float32"), "labels": tf.one_hot(labels, NUM_CLASSES), }, num_parallel_calls=tf.data.AUTOTUNE, ) .map(augmenter, num_parallel_calls=tf.data.AUTOTUNE) .map( lambda data: (data["data"], data["labels"]), num_parallel_calls=tf.data.AUTOTUNE, ) .prefetch(tf.data.AUTOTUNE))val_ds = ( val_ds.shuffle(buffer_size=SHUFFLE_SIZE) .batch(batch_size=BATCH_SIZE) .map( lambda data, labels: { "data": tf.cast(data, "float32"), "labels": tf.one_hot(labels, NUM_CLASSES), }, num_parallel_calls=tf.data.AUTOTUNE, ) .map(augmenter, num_parallel_calls=tf.data.AUTOTUNE) .map( lambda data: (data["data"], data["labels"]), num_parallel_calls=tf.data.AUTOTUNE, ) .cache() .prefetch(tf.data.AUTOTUNE))model = helia.models.build( helia.models.ModelSpec( params=helia.models.EfficientNetParams( input_filters=32, input_kernel_size=(3, 3), input_strides=(2, 2), blocks=[ helia.layers.MBConvParams( filters=48, depth=1, kernel_size=(3, 3), strides=(1, 1), ex_ratio=1, se_ratio=4 ), helia.layers.MBConvParams( filters=64, depth=1, kernel_size=(3, 3), strides=(2, 2), ex_ratio=1, se_ratio=4 ), helia.layers.MBConvParams( filters=96, depth=1, kernel_size=(3, 3), strides=(2, 2), ex_ratio=1, se_ratio=4 ), helia.layers.MBConvParams( filters=128, depth=1, kernel_size=(3, 3), strides=(2, 2), ex_ratio=1, se_ratio=4 ), ], output_filters=0, include_top=True, num_classes=NUM_CLASSES, dropout=0.2, drop_connect_rate=0.2, ), input_shape=(CROP_SIZE, CROP_SIZE, 3), ))flops = helia.metrics.flops.get_flops(model, batch_size=1, fpath=os.devnull)model.summary(layer_range=("inputs", model.layers[10].name))print(f"FLOPS: {flops / 1e6:.2f}M")Saved output
WARNING:tensorflow:From /workspaces/helia-edge/.venv/lib/python3.11/site-packages/tensorflow/python/ops/nn_ops.py:5256: tensor_shape_from_node_def_name (from tensorflow.python.framework.graph_util_impl) is deprecated and will be removed in a future version.Instructions for updating:This API was designed for TensorFlow v1. See https://www.tensorflow.org/guide/migrate for instructions on how to migrate your code to TensorFlow v2.[08/29/24 18:22:29] WARNING WARNING:tensorflow:From ]8;id=231804;file:///workspaces/helia-edge/.venv/lib/python3.11/site-packages/tensorflow/python/util/deprecation.py\deprecation.py]8;;\:]8;id=705631;file:///workspaces/helia-edge/.venv/lib/python3.11/site-packages/tensorflow/python/util/deprecation.py#50\50]8;;\ /workspaces/helia-edge/.venv/lib/python3.11/site-packages/tenso rflow/python/ops/nn_ops.py:5256: tensor_shape_from_node_def_name (from tensorflow.python.framework.graph_util_impl) is deprecated and will be removed in a future version. Instructions for updating: This API was designed for TensorFlow v1. See https://www.tensorflow.org/guide/migrate for instructions on how to migrate your code to TensorFlow v2.Model: "functional"┏━━━━━━━━━━━━━━━━━━━━━┳━━━━━━━━━━━━━━━━━━━┳━━━━━━━━━━━━┳━━━━━━━━━━━━━━━━━━━┓┃ Layer (type) ┃ Output Shape ┃ Param # ┃ Connected to ┃┡━━━━━━━━━━━━━━━━━━━━━╇━━━━━━━━━━━━━━━━━━━╇━━━━━━━━━━━━╇━━━━━━━━━━━━━━━━━━━┩│ inputs (InputLayer) │ (None, 48, 48, 3) │ 0 │ - │├─────────────────────┼───────────────────┼────────────┼───────────────────┤│ stem.conv (Conv2D) │ (None, 24, 24, │ 864 │ inputs[0][0] ││ │ 32) │ │ │├─────────────────────┼───────────────────┼────────────┼───────────────────┤│ stem.bn │ (None, 24, 24, │ 128 │ stem.conv[0][0] ││ (BatchNormalizatio… │ 32) │ │ │├─────────────────────┼───────────────────┼────────────┼───────────────────┤│ stem.act │ (None, 24, 24, │ 0 │ stem.bn[0][0] ││ (Activation) │ 32) │ │ │├─────────────────────┼───────────────────┼────────────┼───────────────────┤│ stage1.mbconv1.dp │ (None, 24, 24, │ 288 │ stem.act[0][0] ││ (DepthwiseConv2D) │ 32) │ │ │├─────────────────────┼───────────────────┼────────────┼───────────────────┤│ stage1.mbconv1.dp.… │ (None, 24, 24, │ 128 │ stage1.mbconv1.d… ││ (BatchNormalizatio… │ 32) │ │ │├─────────────────────┼───────────────────┼────────────┼───────────────────┤│ stage1.mbconv1.dp.… │ (None, 24, 24, │ 0 │ stage1.mbconv1.d… ││ (Activation) │ 32) │ │ │├─────────────────────┼───────────────────┼────────────┼───────────────────┤│ stage1.mbconv1.se.… │ (None, 1, 1, 32) │ 0 │ stage1.mbconv1.d… ││ (GlobalAveragePool… │ │ │ │├─────────────────────┼───────────────────┼────────────┼───────────────────┤│ stage1.mbconv1.se.… │ (None, 1, 1, 8) │ 264 │ stage1.mbconv1.s… ││ (Conv2D) │ │ │ │├─────────────────────┼───────────────────┼────────────┼───────────────────┤│ stage1.mbconv1.se.… │ (None, 1, 1, 8) │ 0 │ stage1.mbconv1.s… ││ (Activation) │ │ │ │├─────────────────────┼───────────────────┼────────────┼───────────────────┤│ stage1.mbconv1.se.… │ (None, 1, 1, 32) │ 288 │ stage1.mbconv1.s… ││ (Conv2D) │ │ │ │├─────────────────────┼───────────────────┼────────────┼───────────────────┤│ stage1.mbconv1.se.… │ (None, 1, 1, 32) │ 0 │ stage1.mbconv1.s… ││ (Activation) │ │ │ │├─────────────────────┼───────────────────┼────────────┼───────────────────┤│ stage1.mbconv1.se.… │ (None, 24, 24, │ 0 │ stage1.mbconv1.d… ││ (Multiply) │ 32) │ │ stage1.mbconv1.s… │└─────────────────────┴───────────────────┴────────────┴───────────────────┘ Total params: 38,406 (150.02 KB) Trainable params: 37,190 (145.27 KB) Non-trainable params: 1,216 (4.75 KB)FLOPS: 5.08MTraining saves the best checkpoint to model.keras in the working directory when this notebook runs. The repository does not include trained weights.
t_mul = 1first_steps = (EPOCHS * len(train_ds)) / (np.power(LR_CYCLES, t_mul) - t_mul + 1)scheduler = keras.optimizers.schedules.CosineDecayRestarts(    initial_learning_rate=LR_RATE,    first_decay_steps=np.ceil(first_steps),    t_mul=t_mul,    m_mul=0.5,)
optimizer = keras.optimizers.Adam(scheduler)loss = keras.losses.CategoricalFocalCrossentropy(from_logits=True)
metrics = [    keras.metrics.CategoricalAccuracy(name="acc"),    keras.metrics.F1Score(name="f1", average="weighted"),]
callbacks = [    keras.callbacks.EarlyStopping(monitor="val_loss", patience=25, restore_best_weights=True, verbose=VERBOSE),    keras.callbacks.ModelCheckpoint(monitor="val_loss", verbose=VERBOSE, save_best_only=True, filepath="model.keras"),]
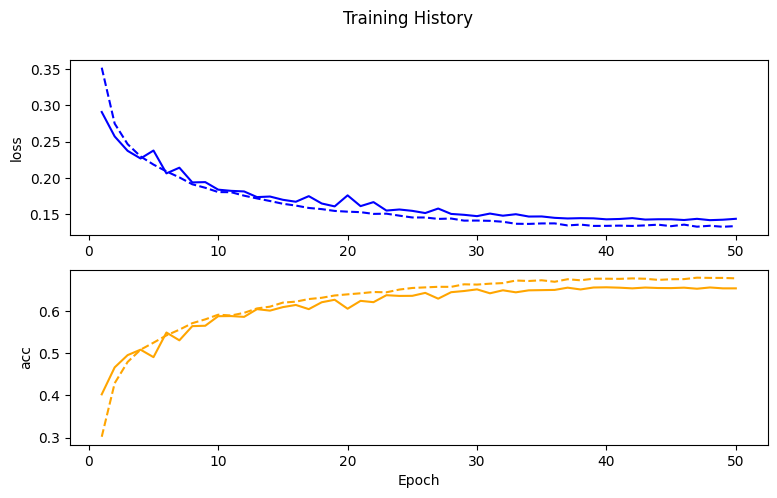
model.compile( optimizer=optimizer, loss=loss, metrics=metrics,)history = model.fit( train_ds, validation_data=val_ds, epochs=EPOCHS, callbacks=callbacks, verbose=VERBOSE,)Saved output
Epoch 1/502024-08-29 18:22:29.789875: E tensorflow/core/util/util.cc:131] oneDNN supports DT_INT32 only on platforms with AVX-512. Falling back to the default Eigen-based implementation if present.WARNING: All log messages before absl::InitializeLog() is called are written to STDERRI0000 00:00:1724955751.896582 209302 service.cc:146] XLA service 0x77e9a0002f90 initialized for platform CUDA (this does not guarantee that XLA will be used). Devices:I0000 00:00:1724955751.896661 209302 service.cc:154] StreamExecutor device (0): NVIDIA GeForce RTX 4090, Compute Capability 8.92024-08-29 18:22:32.062786: I tensorflow/compiler/mlir/tensorflow/utils/dump_mlir_util.cc:268] disabling MLIR crash reproducer, set env var `MLIR_CRASH_REPRODUCER_DIRECTORY` to enable.2024-08-29 18:22:32.346082: I external/local_xla/xla/stream_executor/cuda/cuda_dnn.cc:531] Loaded cuDNN version 8907 27/196 ━━━━━━━━━━━━━━━━━━━━ 1s 6ms/step - acc: 0.1293 - f1: 0.1271 - loss: 0.4749I0000 00:00:1724955756.415054 209302 device_compiler.h:188] Compiled cluster using XLA! This line is logged at most once for the lifetime of the process.196/196 ━━━━━━━━━━━━━━━━━━━━ 0s 25ms/step - acc: 0.2348 - f1: 0.2300 - loss: 0.3985Epoch 1: val_loss improved from inf to 0.29081, saving model to model.keras196/196 ━━━━━━━━━━━━━━━━━━━━ 14s 36ms/step - acc: 0.2351 - f1: 0.2303 - loss: 0.3982 - val_acc: 0.4022 - val_f1: 0.3935 - val_loss: 0.2908Epoch 2/50195/196 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - acc: 0.4083 - f1: 0.4059 - loss: 0.2860Epoch 2: val_loss improved from 0.29081 to 0.25709, saving model to model.keras196/196 ━━━━━━━━━━━━━━━━━━━━ 2s 7ms/step - acc: 0.4085 - f1: 0.4061 - loss: 0.2859 - val_acc: 0.4660 - val_f1: 0.4641 - val_loss: 0.2571Epoch 3/50180/196 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - acc: 0.4687 - f1: 0.4664 - loss: 0.2526Epoch 3: val_loss improved from 0.25709 to 0.23724, saving model to model.keras196/196 ━━━━━━━━━━━━━━━━━━━━ 2s 7ms/step - acc: 0.4696 - f1: 0.4673 - loss: 0.2521 - val_acc: 0.4950 - val_f1: 0.4859 - val_loss: 0.2372Epoch 4/50196/196 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - acc: 0.5023 - f1: 0.4994 - loss: 0.2330Epoch 4: val_loss improved from 0.23724 to 0.22668, saving model to model.keras196/196 ━━━━━━━━━━━━━━━━━━━━ 2s 7ms/step - acc: 0.5023 - f1: 0.4994 - loss: 0.2330 - val_acc: 0.5079 - val_f1: 0.5082 - val_loss: 0.2267Epoch 5/50189/196 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - acc: 0.5213 - f1: 0.5201 - loss: 0.2205Epoch 5: val_loss did not improve from 0.22668196/196 ━━━━━━━━━━━━━━━━━━━━ 2s 7ms/step - acc: 0.5215 - f1: 0.5202 - loss: 0.2204 - val_acc: 0.4902 - val_f1: 0.4825 - val_loss: 0.2376Epoch 6/50187/196 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - acc: 0.5367 - f1: 0.5358 - loss: 0.2120Epoch 6: val_loss improved from 0.22668 to 0.20614, saving model to model.keras196/196 ━━━━━━━━━━━━━━━━━━━━ 2s 8ms/step - acc: 0.5370 - f1: 0.5361 - loss: 0.2118 - val_acc: 0.5485 - val_f1: 0.5481 - val_loss: 0.2061Epoch 7/50193/196 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - acc: 0.5539 - f1: 0.5523 - loss: 0.2018Epoch 7: val_loss did not improve from 0.20614196/196 ━━━━━━━━━━━━━━━━━━━━ 2s 7ms/step - acc: 0.5539 - f1: 0.5524 - loss: 0.2018 - val_acc: 0.5300 - val_f1: 0.5267 - val_loss: 0.2139Epoch 8/50196/196 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - acc: 0.5736 - f1: 0.5724 - loss: 0.1903Epoch 8: val_loss improved from 0.20614 to 0.19365, saving model to model.keras196/196 ━━━━━━━━━━━━━━━━━━━━ 2s 7ms/step - acc: 0.5736 - f1: 0.5724 - loss: 0.1903 - val_acc: 0.5636 - val_f1: 0.5613 - val_loss: 0.1937Epoch 9/50184/196 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - acc: 0.5811 - f1: 0.5801 - loss: 0.1870Epoch 9: val_loss did not improve from 0.19365196/196 ━━━━━━━━━━━━━━━━━━━━ 2s 7ms/step - acc: 0.5809 - f1: 0.5800 - loss: 0.1870 - val_acc: 0.5645 - val_f1: 0.5631 - val_loss: 0.1941Epoch 10/50186/196 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - acc: 0.5879 - f1: 0.5867 - loss: 0.1816Epoch 10: val_loss improved from 0.19365 to 0.18366, saving model to model.keras196/196 ━━━━━━━━━━━━━━━━━━━━ 2s 7ms/step - acc: 0.5880 - f1: 0.5869 - loss: 0.1815 - val_acc: 0.5871 - val_f1: 0.5869 - val_loss: 0.1837Epoch 11/50190/196 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - acc: 0.5861 - f1: 0.5856 - loss: 0.1814Epoch 11: val_loss improved from 0.18366 to 0.18201, saving model to model.keras196/196 ━━━━━━━━━━━━━━━━━━━━ 2s 7ms/step - acc: 0.5862 - f1: 0.5857 - loss: 0.1814 - val_acc: 0.5874 - val_f1: 0.5883 - val_loss: 0.1820Epoch 12/50196/196 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - acc: 0.5939 - f1: 0.5929 - loss: 0.1764Epoch 12: val_loss improved from 0.18201 to 0.18121, saving model to model.keras196/196 ━━━━━━━━━━━━━━━━━━━━ 2s 7ms/step - acc: 0.5939 - f1: 0.5929 - loss: 0.1764 - val_acc: 0.5855 - val_f1: 0.5868 - val_loss: 0.1812Epoch 13/50186/196 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - acc: 0.6016 - f1: 0.6011 - loss: 0.1730Epoch 13: val_loss improved from 0.18121 to 0.17338, saving model to model.keras196/196 ━━━━━━━━━━━━━━━━━━━━ 2s 7ms/step - acc: 0.6018 - f1: 0.6013 - loss: 0.1729 - val_acc: 0.6038 - val_f1: 0.6031 - val_loss: 0.1734Epoch 14/50192/196 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - acc: 0.6101 - f1: 0.6094 - loss: 0.1672Epoch 14: val_loss did not improve from 0.17338196/196 ━━━━━━━━━━━━━━━━━━━━ 2s 7ms/step - acc: 0.6101 - f1: 0.6094 - loss: 0.1672 - val_acc: 0.6003 - val_f1: 0.5985 - val_loss: 0.1742Epoch 15/50184/196 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - acc: 0.6197 - f1: 0.6188 - loss: 0.1647Epoch 15: val_loss improved from 0.17338 to 0.16967, saving model to model.keras196/196 ━━━━━━━━━━━━━━━━━━━━ 2s 7ms/step - acc: 0.6197 - f1: 0.6188 - loss: 0.1646 - val_acc: 0.6086 - val_f1: 0.6083 - val_loss: 0.1697Epoch 16/50193/196 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - acc: 0.6250 - f1: 0.6243 - loss: 0.1591Epoch 16: val_loss improved from 0.16967 to 0.16697, saving model to model.keras196/196 ━━━━━━━━━━━━━━━━━━━━ 2s 7ms/step - acc: 0.6249 - f1: 0.6242 - loss: 0.1592 - val_acc: 0.6137 - val_f1: 0.6116 - val_loss: 0.1670Epoch 17/50191/196 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - acc: 0.6273 - f1: 0.6271 - loss: 0.1588Epoch 17: val_loss did not improve from 0.16697196/196 ━━━━━━━━━━━━━━━━━━━━ 2s 7ms/step - acc: 0.6273 - f1: 0.6271 - loss: 0.1588 - val_acc: 0.6038 - val_f1: 0.6034 - val_loss: 0.1747Epoch 18/50178/196 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - acc: 0.6334 - f1: 0.6330 - loss: 0.1554Epoch 18: val_loss improved from 0.16697 to 0.16457, saving model to model.keras196/196 ━━━━━━━━━━━━━━━━━━━━ 2s 7ms/step - acc: 0.6331 - f1: 0.6327 - loss: 0.1555 - val_acc: 0.6201 - val_f1: 0.6212 - val_loss: 0.1646Epoch 19/50186/196 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - acc: 0.6431 - f1: 0.6422 - loss: 0.1506Epoch 19: val_loss improved from 0.16457 to 0.16057, saving model to model.keras196/196 ━━━━━━━━━━━━━━━━━━━━ 2s 7ms/step - acc: 0.6427 - f1: 0.6418 - loss: 0.1508 - val_acc: 0.6260 - val_f1: 0.6263 - val_loss: 0.1606Epoch 20/50189/196 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - acc: 0.6340 - f1: 0.6332 - loss: 0.1530Epoch 20: val_loss did not improve from 0.16057196/196 ━━━━━━━━━━━━━━━━━━━━ 2s 7ms/step - acc: 0.6342 - f1: 0.6334 - loss: 0.1530 - val_acc: 0.6048 - val_f1: 0.6075 - val_loss: 0.1758Epoch 21/50195/196 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - acc: 0.6385 - f1: 0.6380 - loss: 0.1514Epoch 21: val_loss did not improve from 0.16057196/196 ━━━━━━━━━━━━━━━━━━━━ 1s 7ms/step - acc: 0.6386 - f1: 0.6380 - loss: 0.1514 - val_acc: 0.6234 - val_f1: 0.6246 - val_loss: 0.1609Epoch 22/50187/196 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - acc: 0.6433 - f1: 0.6430 - loss: 0.1500Epoch 22: val_loss did not improve from 0.16057196/196 ━━━━━━━━━━━━━━━━━━━━ 2s 7ms/step - acc: 0.6434 - f1: 0.6430 - loss: 0.1500 - val_acc: 0.6203 - val_f1: 0.6190 - val_loss: 0.1665Epoch 23/50188/196 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - acc: 0.6422 - f1: 0.6419 - loss: 0.1506Epoch 23: val_loss improved from 0.16057 to 0.15481, saving model to model.keras196/196 ━━━━━━━━━━━━━━━━━━━━ 2s 8ms/step - acc: 0.6423 - f1: 0.6419 - loss: 0.1506 - val_acc: 0.6368 - val_f1: 0.6358 - val_loss: 0.1548Epoch 24/50191/196 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - acc: 0.6509 - f1: 0.6507 - loss: 0.1466Epoch 24: val_loss did not improve from 0.15481196/196 ━━━━━━━━━━━━━━━━━━━━ 2s 7ms/step - acc: 0.6509 - f1: 0.6506 - loss: 0.1466 - val_acc: 0.6351 - val_f1: 0.6361 - val_loss: 0.1563Epoch 25/50188/196 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - acc: 0.6570 - f1: 0.6568 - loss: 0.1428Epoch 25: val_loss improved from 0.15481 to 0.15440, saving model to model.keras196/196 ━━━━━━━━━━━━━━━━━━━━ 2s 7ms/step - acc: 0.6569 - f1: 0.6566 - loss: 0.1429 - val_acc: 0.6353 - val_f1: 0.6353 - val_loss: 0.1544Epoch 26/50188/196 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - acc: 0.6549 - f1: 0.6548 - loss: 0.1445Epoch 26: val_loss improved from 0.15440 to 0.15137, saving model to model.keras196/196 ━━━━━━━━━━━━━━━━━━━━ 2s 7ms/step - acc: 0.6549 - f1: 0.6548 - loss: 0.1445 - val_acc: 0.6423 - val_f1: 0.6419 - val_loss: 0.1514Epoch 27/50182/196 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - acc: 0.6555 - f1: 0.6549 - loss: 0.1435Epoch 27: val_loss did not improve from 0.15137196/196 ━━━━━━━━━━━━━━━━━━━━ 2s 7ms/step - acc: 0.6556 - f1: 0.6550 - loss: 0.1435 - val_acc: 0.6286 - val_f1: 0.6324 - val_loss: 0.1576Epoch 28/50188/196 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - acc: 0.6587 - f1: 0.6581 - loss: 0.1426Epoch 28: val_loss improved from 0.15137 to 0.15019, saving model to model.keras196/196 ━━━━━━━━━━━━━━━━━━━━ 2s 7ms/step - acc: 0.6586 - f1: 0.6580 - loss: 0.1427 - val_acc: 0.6439 - val_f1: 0.6456 - val_loss: 0.1502Epoch 29/50191/196 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - acc: 0.6651 - f1: 0.6647 - loss: 0.1385Epoch 29: val_loss improved from 0.15019 to 0.14894, saving model to model.keras196/196 ━━━━━━━━━━━━━━━━━━━━ 2s 7ms/step - acc: 0.6650 - f1: 0.6646 - loss: 0.1386 - val_acc: 0.6467 - val_f1: 0.6453 - val_loss: 0.1489Epoch 30/50191/196 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - acc: 0.6618 - f1: 0.6612 - loss: 0.1405Epoch 30: val_loss improved from 0.14894 to 0.14712, saving model to model.keras196/196 ━━━━━━━━━━━━━━━━━━━━ 2s 7ms/step - acc: 0.6618 - f1: 0.6612 - loss: 0.1406 - val_acc: 0.6506 - val_f1: 0.6499 - val_loss: 0.1471Epoch 31/50192/196 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - acc: 0.6636 - f1: 0.6631 - loss: 0.1408Epoch 31: val_loss did not improve from 0.14712196/196 ━━━━━━━━━━━━━━━━━━━━ 2s 7ms/step - acc: 0.6636 - f1: 0.6631 - loss: 0.1408 - val_acc: 0.6413 - val_f1: 0.6409 - val_loss: 0.1507Epoch 32/50195/196 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - acc: 0.6649 - f1: 0.6646 - loss: 0.1396Epoch 32: val_loss did not improve from 0.14712196/196 ━━━━━━━━━━━━━━━━━━━━ 2s 7ms/step - acc: 0.6649 - f1: 0.6646 - loss: 0.1396 - val_acc: 0.6484 - val_f1: 0.6492 - val_loss: 0.1477Epoch 33/50190/196 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - acc: 0.6757 - f1: 0.6751 - loss: 0.1349Epoch 33: val_loss did not improve from 0.14712196/196 ━━━━━━━━━━━━━━━━━━━━ 2s 7ms/step - acc: 0.6756 - f1: 0.6750 - loss: 0.1350 - val_acc: 0.6436 - val_f1: 0.6450 - val_loss: 0.1498Epoch 34/50180/196 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - acc: 0.6739 - f1: 0.6734 - loss: 0.1336Epoch 34: val_loss improved from 0.14712 to 0.14656, saving model to model.keras196/196 ━━━━━━━━━━━━━━━━━━━━ 2s 7ms/step - acc: 0.6737 - f1: 0.6732 - loss: 0.1338 - val_acc: 0.6483 - val_f1: 0.6482 - val_loss: 0.1466Epoch 35/50185/196 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - acc: 0.6757 - f1: 0.6753 - loss: 0.1356Epoch 35: val_loss did not improve from 0.14656196/196 ━━━━━━━━━━━━━━━━━━━━ 2s 7ms/step - acc: 0.6755 - f1: 0.6751 - loss: 0.1357 - val_acc: 0.6488 - val_f1: 0.6499 - val_loss: 0.1467Epoch 36/50185/196 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - acc: 0.6683 - f1: 0.6677 - loss: 0.1362Epoch 36: val_loss improved from 0.14656 to 0.14477, saving model to model.keras196/196 ━━━━━━━━━━━━━━━━━━━━ 2s 7ms/step - acc: 0.6683 - f1: 0.6677 - loss: 0.1362 - val_acc: 0.6493 - val_f1: 0.6490 - val_loss: 0.1448Epoch 37/50195/196 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - acc: 0.6799 - f1: 0.6800 - loss: 0.1320Epoch 37: val_loss improved from 0.14477 to 0.14390, saving model to model.keras196/196 ━━━━━━━━━━━━━━━━━━━━ 2s 7ms/step - acc: 0.6799 - f1: 0.6799 - loss: 0.1320 - val_acc: 0.6546 - val_f1: 0.6546 - val_loss: 0.1439Epoch 38/50196/196 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - acc: 0.6745 - f1: 0.6742 - loss: 0.1344Epoch 38: val_loss did not improve from 0.14390196/196 ━━━━━━━━━━━━━━━━━━━━ 2s 7ms/step - acc: 0.6745 - f1: 0.6742 - loss: 0.1344 - val_acc: 0.6504 - val_f1: 0.6513 - val_loss: 0.1443Epoch 39/50193/196 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - acc: 0.6820 - f1: 0.6815 - loss: 0.1304Epoch 39: val_loss did not improve from 0.14390196/196 ━━━━━━━━━━━━━━━━━━━━ 2s 7ms/step - acc: 0.6819 - f1: 0.6814 - loss: 0.1305 - val_acc: 0.6550 - val_f1: 0.6550 - val_loss: 0.1441Epoch 40/50190/196 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - acc: 0.6741 - f1: 0.6738 - loss: 0.1341Epoch 40: val_loss improved from 0.14390 to 0.14272, saving model to model.keras196/196 ━━━━━━━━━━━━━━━━━━━━ 2s 8ms/step - acc: 0.6742 - f1: 0.6738 - loss: 0.1341 - val_acc: 0.6555 - val_f1: 0.6554 - val_loss: 0.1427Epoch 41/50187/196 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - acc: 0.6791 - f1: 0.6784 - loss: 0.1309Epoch 41: val_loss did not improve from 0.14272196/196 ━━━━━━━━━━━━━━━━━━━━ 2s 7ms/step - acc: 0.6789 - f1: 0.6782 - loss: 0.1311 - val_acc: 0.6546 - val_f1: 0.6551 - val_loss: 0.1432Epoch 42/50180/196 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - acc: 0.6806 - f1: 0.6796 - loss: 0.1323Epoch 42: val_loss did not improve from 0.14272196/196 ━━━━━━━━━━━━━━━━━━━━ 2s 7ms/step - acc: 0.6803 - f1: 0.6793 - loss: 0.1324 - val_acc: 0.6530 - val_f1: 0.6543 - val_loss: 0.1444Epoch 43/50190/196 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - acc: 0.6726 - f1: 0.6723 - loss: 0.1356Epoch 43: val_loss improved from 0.14272 to 0.14239, saving model to model.keras196/196 ━━━━━━━━━━━━━━━━━━━━ 2s 8ms/step - acc: 0.6727 - f1: 0.6724 - loss: 0.1355 - val_acc: 0.6549 - val_f1: 0.6553 - val_loss: 0.1424Epoch 44/50189/196 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - acc: 0.6697 - f1: 0.6692 - loss: 0.1366Epoch 44: val_loss did not improve from 0.14239196/196 ━━━━━━━━━━━━━━━━━━━━ 2s 7ms/step - acc: 0.6698 - f1: 0.6693 - loss: 0.1366 - val_acc: 0.6538 - val_f1: 0.6547 - val_loss: 0.1428Epoch 45/50178/196 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - acc: 0.6771 - f1: 0.6769 - loss: 0.1322Epoch 45: val_loss did not improve from 0.14239196/196 ━━━━━━━━━━━━━━━━━━━━ 2s 7ms/step - acc: 0.6768 - f1: 0.6766 - loss: 0.1323 - val_acc: 0.6536 - val_f1: 0.6542 - val_loss: 0.1428Epoch 46/50195/196 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - acc: 0.6685 - f1: 0.6683 - loss: 0.1386Epoch 46: val_loss improved from 0.14239 to 0.14178, saving model to model.keras196/196 ━━━━━━━━━━━━━━━━━━━━ 2s 8ms/step - acc: 0.6686 - f1: 0.6683 - loss: 0.1386 - val_acc: 0.6546 - val_f1: 0.6548 - val_loss: 0.1418Epoch 47/50181/196 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - acc: 0.6797 - f1: 0.6794 - loss: 0.1315Epoch 47: val_loss did not improve from 0.14178196/196 ━━━━━━━━━━━━━━━━━━━━ 2s 7ms/step - acc: 0.6796 - f1: 0.6793 - loss: 0.1316 - val_acc: 0.6521 - val_f1: 0.6532 - val_loss: 0.1434Epoch 48/50182/196 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - acc: 0.6743 - f1: 0.6736 - loss: 0.1347Epoch 48: val_loss improved from 0.14178 to 0.14157, saving model to model.keras196/196 ━━━━━━━━━━━━━━━━━━━━ 2s 7ms/step - acc: 0.6745 - f1: 0.6739 - loss: 0.1346 - val_acc: 0.6551 - val_f1: 0.6553 - val_loss: 0.1416Epoch 49/50187/196 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - acc: 0.6798 - f1: 0.6796 - loss: 0.1319Epoch 49: val_loss did not improve from 0.14157196/196 ━━━━━━━━━━━━━━━━━━━━ 1s 7ms/step - acc: 0.6797 - f1: 0.6795 - loss: 0.1319 - val_acc: 0.6530 - val_f1: 0.6528 - val_loss: 0.1422Epoch 50/50194/196 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - acc: 0.6764 - f1: 0.6762 - loss: 0.1334Epoch 50: val_loss did not improve from 0.14157196/196 ━━━━━━━━━━━━━━━━━━━━ 2s 7ms/step - acc: 0.6765 - f1: 0.6762 - loss: 0.1334 - val_acc: 0.6530 - val_f1: 0.6540 - val_loss: 0.1435Restoring model weights from the end of the best epoch: 48._ = helia.plotting.plot_history_metrics( history=history.history, metrics=["loss", "acc"], title="Training History", stack=True)Saved output