ECG Foundation Model
This example displays saved outputs. Building the documentation does not run training. Check dataset paths for your notebook working directory before running.
Date created: 2024/07/25
Last Modified: 2024/08/14
Description: Train, evaluate, and export an ECG foundation model
Overview
Section titled “Overview”This notebook demonstrates creating a foundation model for raw ECG signals. By creating a foundation model, we can create small, down-stream classification models.
#!pip install -q --disable-pip-version-check heartkitimport os
os.environ["TF_CPP_MIN_LOG_LEVEL"] = "2" # 3import contextlibfrom pathlib import Pathimport tempfileimport kerasimport heartkit as hkimport tensorflow as tfimport numpy as npimport helia_edge as heliaimport matplotlib.pyplot as pltfrom sklearn.manifold import TSNE2024-08-16 18:53:16.603880: E external/local_xla/xla/stream_executor/cuda/cuda_fft.cc:485] Unable to register cuFFT factory: Attempting to register factory for plugin cuFFT when one has already been registered2024-08-16 18:53:16.611916: E external/local_xla/xla/stream_executor/cuda/cuda_dnn.cc:8454] Unable to register cuDNN factory: Attempting to register factory for plugin cuDNN when one has already been registered2024-08-16 18:53:16.614257: E external/local_xla/xla/stream_executor/cuda/cuda_blas.cc:1452] Unable to register cuBLAS factory: Attempting to register factory for plugin cuBLAS when one has already been registeredConstants
Section titled “Constants”Here we provide the constants that we will use throughout the guide. For better performance, adjust parameters such as BATCH_SIZE, EPOCHS, and LEARNING_RATE.
# File pathsdatasets_dir = Path(os.getenv("HK_DATASET_PATH", "./datasets"))job_dir = Path(tempfile.gettempdir()) / "hk-foundation"model_file = job_dir / "model.keras"val_file = job_dir / "val.pkl"
# Data settingssampling_rate = 100  # 100 Hzinput_size = 1000  # 10 secondsframe_size = 800  # 8 seconds
# Training settingsbatch_size = 1024  # Batch size for trainingbuffer_size = 2000  # How many samples are shuffled each epochepochs = 150  # Increase this to 100+steps_per_epoch = 25  # # Steps per epoch (must set since ds has unknown size)samples_per_patient = 1  # Number of samples per patientval_metric = "loss"  # Metric to monitor for early stoppingval_mode = "min"  # Mode for early stoppingval_size = 10000  # Number of samples used for validationlearning_rate = 1e-3  # Learning rate for Adam optimizerepsilon = 0.001
# Model settingsprojection_width = 128temperature = 0.1
# Other settingsseed = 42 # Seed for reproducibilityverbose = 1 # Verbosity levelplot_theme = hk.utils.dark_themehelia.utils.silence_tensorflow()hk.utils.setup_plotting(plot_theme)logger = helia.utils.setup_logger(__name__, level=verbose)
os.makedirs(job_dir, exist_ok=True)logger.info(f"Job directory: {job_dir}")INFO Job directory: /tmp/hk-foundation 1079341004.py:6Configure datasets
Section titled “Configure datasets”We are going to train our model using two large datasets: the PTB-XL dataset and the large-scale arrhythmia dataset.
datasets = [ hk.NamedParams(name="lsad", params=dict(path=datasets_dir / "lsad")), hk.NamedParams(name="ptbxl", params=dict(path=datasets_dir / "ptbxl")),]Download datasets
Section titled “Download datasets”for dataset in datasets: ds = hk.DatasetFactory.get(dataset.name)(**dataset.params) ds.download(force=False)Create data pipeline
Section titled “Create data pipeline”Next, we will create a tf.data pipeline by performing the following steps on each dataset:
- Loading dataset class handler
- Leverage task specific data loader for given dataset
- Splittiing the dataset into training and validation sets
- Creating
tf.data.Datasetobjects for training and validation
After creating all the tf.data.Dataset objects, we will merge them into a single dataset for training and validation.
# Load datasetsdsets = [hk.DatasetFactory.get(ds.name)(**ds.params) for ds in datasets]dset_weights = np.array([0.5, 0.5])
train_datasets = []val_datasets = []for ds in dsets: # Create dataloader specific to dataset dataloader = hk.tasks.foundation.FoundationTaskFactory.get(ds.name)( ds=ds, frame_size=frame_size, sampling_rate=sampling_rate, )
# Split patients into train and validation sets train_patients, val_patients = dataloader.split_train_val_patients()
# Create train dataset train_ds = dataloader.create_dataloader( patient_ids=train_patients, samples_per_patient=samples_per_patient, shuffle=True )
# Create validation dataset val_ds = dataloader.create_dataloader( patient_ids=val_patients, samples_per_patient=samples_per_patient, shuffle=False ) train_datasets.append(train_ds) val_datasets.append(val_ds)# END FOR
# Combine datasetstrain_ds = tf.data.Dataset.sample_from_datasets(train_datasets, weights=dset_weights)val_ds = tf.data.Dataset.sample_from_datasets(val_datasets, weights=dset_weights)WARNING: All log messages before absl::InitializeLog() is called are written to STDERRI0000 00:00:1723834403.812869 712291 cuda_executor.cc:1015] successful NUMA node read from SysFS had negative value (-1), but there must be at least one NUMA node, so returning NUMA node zero. See more at https://github.com/torvalds/linux/blob/v6.0/Documentation/ABI/testing/sysfs-bus-pci#L344-L355I0000 00:00:1723834403.835711 712291 cuda_executor.cc:1015] successful NUMA node read from SysFS had negative value (-1), but there must be at least one NUMA node, so returning NUMA node zero. See more at https://github.com/torvalds/linux/blob/v6.0/Documentation/ABI/testing/sysfs-bus-pci#L344-L355I0000 00:00:1723834403.835842 712291 cuda_executor.cc:1015] successful NUMA node read from SysFS had negative value (-1), but there must be at least one NUMA node, so returning NUMA node zero. See more at https://github.com/torvalds/linux/blob/v6.0/Documentation/ABI/testing/sysfs-bus-pci#L344-L355I0000 00:00:1723834403.837216 712291 cuda_executor.cc:1015] successful NUMA node read from SysFS had negative value (-1), but there must be at least one NUMA node, so returning NUMA node zero. See more at https://github.com/torvalds/linux/blob/v6.0/Documentation/ABI/testing/sysfs-bus-pci#L344-L355I0000 00:00:1723834403.837303 712291 cuda_executor.cc:1015] successful NUMA node read from SysFS had negative value (-1), but there must be at least one NUMA node, so returning NUMA node zero. See more at https://github.com/torvalds/linux/blob/v6.0/Documentation/ABI/testing/sysfs-bus-pci#L344-L355I0000 00:00:1723834403.837349 712291 cuda_executor.cc:1015] successful NUMA node read from SysFS had negative value (-1), but there must be at least one NUMA node, so returning NUMA node zero. See more at https://github.com/torvalds/linux/blob/v6.0/Documentation/ABI/testing/sysfs-bus-pci#L344-L355I0000 00:00:1723834403.890424 712291 cuda_executor.cc:1015] successful NUMA node read from SysFS had negative value (-1), but there must be at least one NUMA node, so returning NUMA node zero. See more at https://github.com/torvalds/linux/blob/v6.0/Documentation/ABI/testing/sysfs-bus-pci#L344-L355I0000 00:00:1723834403.890527 712291 cuda_executor.cc:1015] successful NUMA node read from SysFS had negative value (-1), but there must be at least one NUMA node, so returning NUMA node zero. See more at https://github.com/torvalds/linux/blob/v6.0/Documentation/ABI/testing/sysfs-bus-pci#L344-L355I0000 00:00:1723834403.890585 712291 cuda_executor.cc:1015] successful NUMA node read from SysFS had negative value (-1), but there must be at least one NUMA node, so returning NUMA node zero. See more at https://github.com/torvalds/linux/blob/v6.0/Documentation/ABI/testing/sysfs-bus-pci#L344-L355Visualize the data
Section titled “Visualize the data”Let’s visualize a sample ECG signal from the synthetic dataset. Note this contains no noise or artifacts. Augmentations will be applied later to generate noisy samples for training.
ecg1, ecg2 = next(iter(train_ds))ecg1, ecg2 = ecg1.numpy().squeeze(), ecg2.numpy().squeeze()
ts = np.arange(0, len(ecg1)) / sampling_ratefig, ax = plt.subplots(1, 1, figsize=(9, 4))ax.plot(ts, ecg1, color=plot_theme.primary_color, lw=3)ax.plot(ts, ecg2, color=plot_theme.secondary_color, lw=3)fig.suptitle("Raw ECG Signal")ax.set_xlabel("Time (s)")ax.set_ylabel("Amplitude")fig.tight_layout()fig.show()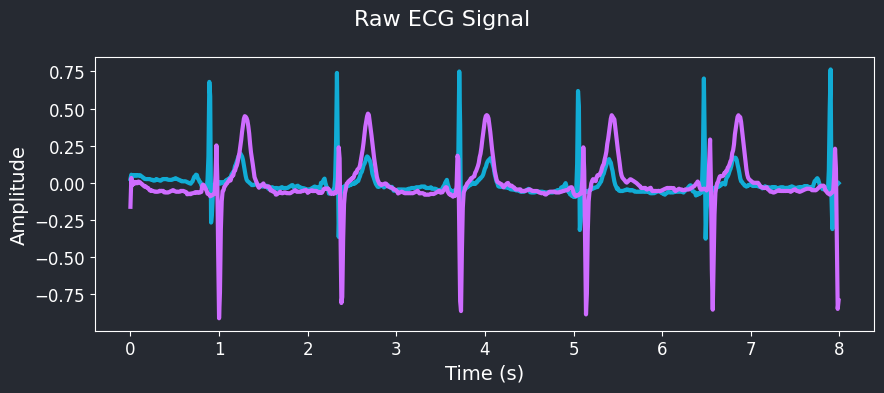
Create augmentation pipeline
Section titled “Create augmentation pipeline”To enable self-supervised training to learn useful features from raw ECG signals, we need to create an augmentation pipeline. Each sample will be augmented into two different ways. Using contrastive learning, the model should generate features that are similar for the same sample and different for different samples.
nstdb = hk.datasets.nstdb.NstdbNoise(target_rate=sampling_rate)noises = np.hstack(    (nstdb.get_noise(noise_type="bw"), nstdb.get_noise(noise_type="ma"), nstdb.get_noise(noise_type="em")))noises = noises.astype(np.float32)
preprocessor = helia.layers.preprocessing.LayerNormalization1D(epsilon=epsilon, name="LayerNormalization")
augmenter = helia.layers.preprocessing.AugmentationPipeline(    layers=[        helia.layers.preprocessing.RandomNoiseDistortion1D(            sample_rate=sampling_rate, amplitude=(0, 1.0), frequency=(0.5, 1.5), name="BaselineWander"        ),        helia.layers.preprocessing.RandomSineWave(            sample_rate=sampling_rate, amplitude=(0, 0.05), frequency=(45, 50), name="PowerlineNoise"        ),        helia.layers.preprocessing.AmplitudeWarp(            sample_rate=sampling_rate, amplitude=(0.9, 1.1), frequency=(0.5, 1.5), name="AmplitudeWarp"        ),        helia.layers.preprocessing.RandomGaussianNoise1D(factor=(0.05, 0.2), name="GaussianNoise"),        helia.layers.preprocessing.RandomBackgroundNoises1D(            noises=noises, amplitude=(0.05, 0.2), num_noises=2, name="RandomBackgroundNoises"        ),        helia.layers.preprocessing.RandomCutout1D(            factor=(0.01, 0.05), cutouts=2, fill_mode="constant", fill_value=0.0, name="RandomCutout"        ),        helia.layers.preprocessing.RandomCrop1D(duration=frame_size, name="RandomCrop", auto_vectorize=True),    ],)
Visualize augmented pair
Section titled “Visualize augmented pair”aug_ecg1 = augmenter(preprocessor(keras.ops.convert_to_tensor(np.reshape(ecg1, (1, -1, 1)))), training=True)aug_ecg1 = aug_ecg1.numpy().squeeze()
aug_ecg2 = augmenter(preprocessor(keras.ops.convert_to_tensor(np.reshape(ecg2, (1, -1, 1)))), training=True)aug_ecg2 = aug_ecg2.numpy().squeeze()
ts = np.arange(0, frame_size, 1) / sampling_rate
fig, ax = plt.subplots(1, 1, figsize=(9, 4))plt.title("Augmented ECG")plt.plot(ts, aug_ecg1, color=plot_theme.primary_color, lw=2)plt.plot(ts, aug_ecg2, color=plot_theme.secondary_color, lw=2)ax.set_xlabel("Time (s)")ax.set_ylabel("Amplitude")plt.show()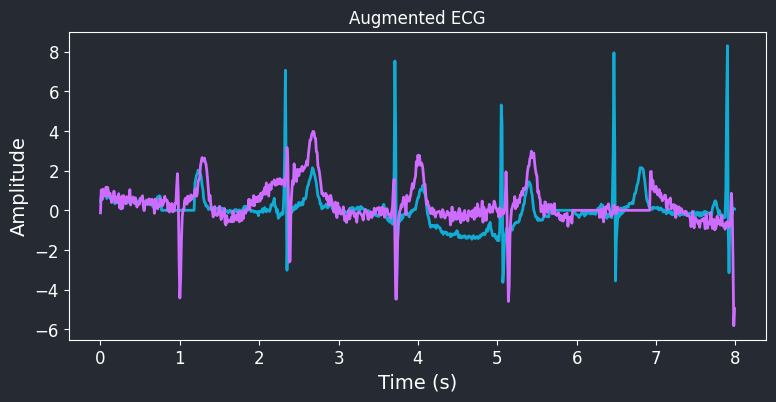
Create full data pipeline w/ augmentation
Section titled “Create full data pipeline w/ augmentation”We will now create a full data pipeline by extended the original with shuffling, batching, augmentations, and prefetching.
For validation, we will cache a subset of the validation data to speed up the evaluation process.
train_ds = (    train_ds.shuffle(        buffer_size=buffer_size,        reshuffle_each_iteration=True,    )    .batch(        batch_size=batch_size,        drop_remainder=True,        num_parallel_calls=tf.data.AUTOTUNE,    )    .map(        lambda x1, x2: {            helia.trainers.SimCLRTrainer.SAMPLES: x1,            helia.trainers.SimCLRTrainer.AUG_SAMPLES_0: augmenter(preprocessor(x1), training=True),            helia.trainers.SimCLRTrainer.AUG_SAMPLES_1: augmenter(preprocessor(x2), training=True),        },        num_parallel_calls=tf.data.AUTOTUNE,    )    .prefetch(tf.data.AUTOTUNE))
val_ds = (    val_ds.batch(        batch_size=batch_size,        drop_remainder=True,        num_parallel_calls=tf.data.AUTOTUNE,    )    .map(        lambda x1, x2: {            helia.trainers.SimCLRTrainer.SAMPLES: x1,            helia.trainers.SimCLRTrainer.AUG_SAMPLES_0: augmenter(preprocessor(x1), training=True),            helia.trainers.SimCLRTrainer.AUG_SAMPLES_1: augmenter(preprocessor(x2), training=True),        },        num_parallel_calls=tf.data.AUTOTUNE,    )    .prefetch(tf.data.AUTOTUNE))
# Cache the validation datasetval_ds = val_ds.take(val_size // batch_size).cache()
Define encoder model
Section titled “Define encoder model”For this task, we are going to leverage a customized EfficientNetV2 model architecture for the encoder that is smaller and can handle 1D signals. The model consists of 5 main MBConv blocks with a global average pooling layer and a dense layer for classification.
inputs = keras.Input(shape=(frame_size, 1), name="input")
encoder_params = dict(    input_filters=24,    input_kernel_size=(1, 9),    input_strides=(1, 2),    blocks=[        dict(filters=32, depth=2, kernel_size=(1, 9), strides=(1, 2), ex_ratio=1, se_ratio=4, norm="layer"),        dict(filters=48, depth=2, kernel_size=(1, 9), strides=(1, 2), ex_ratio=1, se_ratio=4, norm="layer"),        dict(filters=64, depth=2, kernel_size=(1, 9), strides=(1, 2), ex_ratio=1, se_ratio=4, norm="layer"),        dict(filters=80, depth=1, kernel_size=(1, 9), strides=(1, 2), ex_ratio=1, se_ratio=4, norm="layer"),        dict(filters=96, depth=1, kernel_size=(1, 9), strides=(1, 2), ex_ratio=1, se_ratio=4, norm="layer"),    ],    output_filters=projection_width,    include_top=True,)
encoder = helia.models.efficientnet.efficientnetv2_from_object(x=inputs, params=encoder_params, num_classes=None)
Visualize the model
Section titled “Visualize the model”Let’s view the encoder to understand the architecture better.
encoder.summary(print_fn=logger.info, layer_range=("input", encoder.layers[10].name))flops = helia.metrics.flops.get_flops(encoder, batch_size=1, fpath=os.devnull)logger.info(f"Computation: {flops / 1e6:0.2f} MFLOPs")encoder_output = encoder(inputs)Saved output
INFO Model: "EfficientNetV2" summary_utils.py:389 ┏━━━━━━━━━━━━━━━━━━━━━┳━━━━━━━━━━━━━━━━━━━┳━━━━━━━━━━━━┳━━━━━━━━━━━━━━━━━━━┓ ┃ Layer (type) ┃ Output Shape ┃ Param # ┃ Connected to ┃ ┡━━━━━━━━━━━━━━━━━━━━━╇━━━━━━━━━━━━━━━━━━━╇━━━━━━━━━━━━╇━━━━━━━━━━━━━━━━━━━┩ │ input (InputLayer) │ (None, 800, 1) │ 0 │ - │ ├─────────────────────┼───────────────────┼────────────┼───────────────────┤ │ reshape (Reshape) │ (None, 1, 800, 1) │ 0 │ input[0][0] │ ├─────────────────────┼───────────────────┼────────────┼───────────────────┤ │ stem.conv (Conv2D) │ (None, 1, 400, │ 216 │ reshape[0][0] │ │ │ 24) │ │ │ ├─────────────────────┼───────────────────┼────────────┼───────────────────┤ │ stem.bn │ (None, 1, 400, │ 96 │ stem.conv[0][0] │ │ (BatchNormalizatio… │ 24) │ │ │ ├─────────────────────┼───────────────────┼────────────┼───────────────────┤ │ stem.act │ (None, 1, 400, │ 0 │ stem.bn[0][0] │ │ (Activation) │ 24) │ │ │ ├─────────────────────┼───────────────────┼────────────┼───────────────────┤ │ stage1.mbconv1.dp │ (None, 1, 400, │ 216 │ stem.act[0][0] │ │ (DepthwiseConv2D) │ 24) │ │ │ ├─────────────────────┼───────────────────┼────────────┼───────────────────┤ │ stage1.mbconv1.dp.… │ (None, 1, 400, │ 96 │ stage1.mbconv1.d… │ │ (BatchNormalizatio… │ 24) │ │ │ ├─────────────────────┼───────────────────┼────────────┼───────────────────┤ │ stage1.mbconv1.dp.… │ (None, 1, 400, │ 0 │ stage1.mbconv1.d… │ │ (Activation) │ 24) │ │ │ ├─────────────────────┼───────────────────┼────────────┼───────────────────┤ │ max_pooling2d │ (None, 1, 200, │ 0 │ stage1.mbconv1.d… │ │ (MaxPooling2D) │ 24) │ │ │ ├─────────────────────┼───────────────────┼────────────┼───────────────────┤ │ stage1.mbconv1.se.… │ (None, 1, 1, 24) │ 0 │ max_pooling2d[0]… │ │ (GlobalAveragePool… │ │ │ │ ├─────────────────────┼───────────────────┼────────────┼───────────────────┤ │ stage1.mbconv1.se.… │ (None, 1, 1, 6) │ 150 │ stage1.mbconv1.s… │ │ (Conv2D) │ │ │ │ └─────────────────────┴───────────────────┴────────────┴───────────────────┘ Total params: 57,066 (222.91 KB) Trainable params: 55,050 (215.04 KB) Non-trainable params: 2,016 (7.88 KB)INFO Computation: 4.17 MFLOPs 909537700.py:3projector_input = encoder_outputprojector_output = keras.layers.Dense(projection_width, activation="relu6")(projector_input)projector_output = keras.layers.Dense(projection_width)(projector_output)projector = keras.Model(inputs=projector_input, outputs=projector_output, name="projector")flops = helia.metrics.flops.get_flops(projector, batch_size=1, fpath=os.devnull)projector.summary(print_fn=logger.info)logger.debug(f"Projector requires {flops / 1e6:0.2f} MFLOPS")Saved output
INFO Model: "projector" summary_utils.py:389 ┏━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━┳━━━━━━━━━━━━━━━━━━━━━━━━┳━━━━━━━━━━━━━━━┓ ┃ Layer (type) ┃ Output Shape ┃ Param # ┃ ┡━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━╇━━━━━━━━━━━━━━━━━━━━━━━━╇━━━━━━━━━━━━━━━┩ │ keras_tensor_109CLONE │ (None, 128) │ 0 │ │ (InputLayer) │ │ │ ├─────────────────────────────────┼────────────────────────┼───────────────┤ │ dense (Dense) │ (None, 128) │ 16,512 │ ├─────────────────────────────────┼────────────────────────┼───────────────┤ │ dense_1 (Dense) │ (None, 128) │ 16,512 │ └─────────────────────────────────┴────────────────────────┴───────────────┘ Total params: 33,024 (129.00 KB) Trainable params: 33,024 (129.00 KB) Non-trainable params: 0 (0.00 B)Create a SimCLR model to train
Section titled “Create a SimCLR model to train”model = helia.trainers.SimCLRTrainer( encoder=encoder, augmenter=None, # We augment in the data pipeline projector=projector,)Compile the model
Section titled “Compile the model”We will compile the model using Adam optimizer with cosine learning rate scheduler and custom cosine similarity loss function. We will also attach metrics and callbacks to monitor the training process.
def get_scheduler():    return keras.optimizers.schedules.CosineDecay(        initial_learning_rate=learning_rate,        decay_steps=steps_per_epoch * epochs,    )

optimizer = keras.optimizers.Adam(get_scheduler())loss = helia.losses.simclr.SimCLRLoss(temperature=temperature)
metrics = [    keras.metrics.MeanSquaredError(name="mse"),    keras.metrics.CosineSimilarity(name="cos"),]
model_callbacks = [    keras.callbacks.EarlyStopping(        monitor=f"val_{val_metric}",        patience=max(int(0.25 * epochs), 1),        mode=val_mode,        restore_best_weights=True,        verbose=verbose - 1,    ),    keras.callbacks.ModelCheckpoint(        filepath=str(model_file), monitor=f"val_{val_metric}", save_best_only=True, mode=val_mode, verbose=verbose - 1    ),    keras.callbacks.CSVLogger(job_dir / "history.csv"),]if helia.utils.env_flag("TENSORBOARD"):    model_callbacks.append(        keras.callbacks.TensorBoard(            log_dir=job_dir,            write_steps_per_second=True,        )    )
model.compile(    encoder_optimizer=optimizer,    encoder_loss=loss,    encoder_metrics=metrics,)
Train the model
Section titled “Train the model”history = model.fit( train_ds, steps_per_epoch=steps_per_epoch, verbose=verbose, epochs=epochs, validation_data=val_ds, callbacks=model_callbacks,)Epoch 1/1502024-08-16 18:54:13.839587: E tensorflow/core/util/util.cc:131] oneDNN supports DT_INT32 only on platforms with AVX-512. Falling back to the default Eigen-based implementation if present.WARNING: All log messages before absl::InitializeLog() is called are written to STDERRI0000 00:00:1723834463.457755 712486 service.cc:146] XLA service 0x78321c02f130 initialized for platform CUDA (this does not guarantee that XLA will be used). Devices:I0000 00:00:1723834463.457771 712486 service.cc:154] StreamExecutor device (0): NVIDIA GeForce RTX 4090, Compute Capability 8.9 1/25 ━━━━━━━━━━━━━━━━━━━━ 13:39 34s/step - cos: 0.5956 - loss: 15.6336 - mse: 0.2352I0000 00:00:1723834487.410060 712486 device_compiler.h:188] Compiled cluster using XLA! This line is logged at most once for the lifetime of the process.Saved output
25/25 ━━━━━━━━━━━━━━━━━━━━ 67s 1s/step - cos: 0.6157 - loss: 14.9098 - mse: 0.2319 - val_cos: 0.6770 - val_loss: 12.6894 - val_mse: 0.2770Epoch 2/15025/25 ━━━━━━━━━━━━━━━━━━━━ 6s 228ms/step - cos: 0.6928 - loss: 12.2036 - mse: 0.2814 - val_cos: 0.7274 - val_loss: 11.2915 - val_mse: 0.2797Epoch 3/15025/25 ━━━━━━━━━━━━━━━━━━━━ 5s 183ms/step - cos: 0.7322 - loss: 11.1098 - mse: 0.2783 - val_cos: 0.7428 - val_loss: 10.5851 - val_mse: 0.2743Epoch 4/15025/25 ━━━━━━━━━━━━━━━━━━━━ 5s 185ms/step - cos: 0.7449 - loss: 10.4056 - mse: 0.2715 - val_cos: 0.7517 - val_loss: 9.9517 - val_mse: 0.2724Epoch 5/15025/25 ━━━━━━━━━━━━━━━━━━━━ 5s 184ms/step - cos: 0.7523 - loss: 9.8387 - mse: 0.2707 - val_cos: 0.7568 - val_loss: 9.5624 - val_mse: 0.2703Epoch 6/15025/25 ━━━━━━━━━━━━━━━━━━━━ 5s 183ms/step - cos: 0.7548 - loss: 9.5425 - mse: 0.2690 - val_cos: 0.7591 - val_loss: 9.2802 - val_mse: 0.2633Epoch 7/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 179ms/step - cos: 0.7587 - loss: 9.2489 - mse: 0.2617 - val_cos: 0.7604 - val_loss: 9.0665 - val_mse: 0.2585Epoch 8/15025/25 ━━━━━━━━━━━━━━━━━━━━ 5s 185ms/step - cos: 0.7604 - loss: 9.0068 - mse: 0.2579 - val_cos: 0.7623 - val_loss: 8.8123 - val_mse: 0.2564Epoch 9/15025/25 ━━━━━━━━━━━━━━━━━━━━ 5s 182ms/step - cos: 0.7618 - loss: 8.7503 - mse: 0.2550 - val_cos: 0.7628 - val_loss: 8.5923 - val_mse: 0.2538Epoch 10/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 179ms/step - cos: 0.7621 - loss: 8.5523 - mse: 0.2549 - val_cos: 0.7622 - val_loss: 8.4131 - val_mse: 0.2523Epoch 11/15025/25 ━━━━━━━━━━━━━━━━━━━━ 5s 186ms/step - cos: 0.7624 - loss: 8.3957 - mse: 0.2511 - val_cos: 0.7635 - val_loss: 8.2374 - val_mse: 0.2495Epoch 12/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 181ms/step - cos: 0.7637 - loss: 8.2014 - mse: 0.2498 - val_cos: 0.7641 - val_loss: 8.0899 - val_mse: 0.2478Epoch 13/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 181ms/step - cos: 0.7639 - loss: 8.0752 - mse: 0.2456 - val_cos: 0.7645 - val_loss: 7.9631 - val_mse: 0.2451Epoch 14/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 177ms/step - cos: 0.7638 - loss: 7.9306 - mse: 0.2457 - val_cos: 0.7665 - val_loss: 7.8171 - val_mse: 0.2403Epoch 15/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 182ms/step - cos: 0.7642 - loss: 7.8377 - mse: 0.2410 - val_cos: 0.7663 - val_loss: 7.7359 - val_mse: 0.2385Epoch 16/15025/25 ━━━━━━━━━━━━━━━━━━━━ 5s 185ms/step - cos: 0.7658 - loss: 7.6886 - mse: 0.2378 - val_cos: 0.7676 - val_loss: 7.6044 - val_mse: 0.2350Epoch 17/15025/25 ━━━━━━━━━━━━━━━━━━━━ 5s 188ms/step - cos: 0.7643 - loss: 7.6359 - mse: 0.2369 - val_cos: 0.7659 - val_loss: 7.5199 - val_mse: 0.2345Epoch 18/15025/25 ━━━━━━━━━━━━━━━━━━━━ 5s 184ms/step - cos: 0.7660 - loss: 7.5126 - mse: 0.2329 - val_cos: 0.7680 - val_loss: 7.4207 - val_mse: 0.2301Epoch 19/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 177ms/step - cos: 0.7651 - loss: 7.4191 - mse: 0.2304 - val_cos: 0.7682 - val_loss: 7.3130 - val_mse: 0.2268Epoch 20/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 182ms/step - cos: 0.7651 - loss: 7.3419 - mse: 0.2291 - val_cos: 0.7664 - val_loss: 7.2225 - val_mse: 0.2272Epoch 21/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 179ms/step - cos: 0.7657 - loss: 7.2691 - mse: 0.2277 - val_cos: 0.7665 - val_loss: 7.1630 - val_mse: 0.2245Epoch 22/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 182ms/step - cos: 0.7640 - loss: 7.2177 - mse: 0.2248 - val_cos: 0.7662 - val_loss: 7.0724 - val_mse: 0.2219Epoch 23/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 181ms/step - cos: 0.7679 - loss: 7.0468 - mse: 0.2195 - val_cos: 0.7680 - val_loss: 6.9664 - val_mse: 0.2184Epoch 24/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 178ms/step - cos: 0.7667 - loss: 6.9840 - mse: 0.2171 - val_cos: 0.7669 - val_loss: 6.9237 - val_mse: 0.2178Epoch 25/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 181ms/step - cos: 0.7662 - loss: 6.9243 - mse: 0.2169 - val_cos: 0.7666 - val_loss: 6.8773 - val_mse: 0.2136Epoch 26/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 180ms/step - cos: 0.7655 - loss: 6.8518 - mse: 0.2143 - val_cos: 0.7668 - val_loss: 6.7758 - val_mse: 0.2124Epoch 27/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 181ms/step - cos: 0.7667 - loss: 6.7623 - mse: 0.2110 - val_cos: 0.7664 - val_loss: 6.7287 - val_mse: 0.2101Epoch 28/15025/25 ━━━━━━━━━━━━━━━━━━━━ 5s 184ms/step - cos: 0.7676 - loss: 6.7556 - mse: 0.2077 - val_cos: 0.7678 - val_loss: 6.6686 - val_mse: 0.2059Epoch 29/15025/25 ━━━━━━━━━━━━━━━━━━━━ 5s 191ms/step - cos: 0.7671 - loss: 6.6939 - mse: 0.2065 - val_cos: 0.7670 - val_loss: 6.6024 - val_mse: 0.2012Epoch 30/15025/25 ━━━━━━━━━━━━━━━━━━━━ 5s 186ms/step - cos: 0.7660 - loss: 6.6050 - mse: 0.2017 - val_cos: 0.7678 - val_loss: 6.5662 - val_mse: 0.1994Epoch 31/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 180ms/step - cos: 0.7667 - loss: 6.5798 - mse: 0.2007 - val_cos: 0.7677 - val_loss: 6.5317 - val_mse: 0.1979Epoch 32/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 180ms/step - cos: 0.7669 - loss: 6.5304 - mse: 0.1988 - val_cos: 0.7691 - val_loss: 6.4457 - val_mse: 0.1951Epoch 33/15025/25 ━━━━━━━━━━━━━━━━━━━━ 5s 184ms/step - cos: 0.7671 - loss: 6.4863 - mse: 0.1965 - val_cos: 0.7678 - val_loss: 6.4010 - val_mse: 0.1941Epoch 34/15025/25 ━━━━━━━━━━━━━━━━━━━━ 5s 185ms/step - cos: 0.7666 - loss: 6.4082 - mse: 0.1940 - val_cos: 0.7678 - val_loss: 6.3757 - val_mse: 0.1933Epoch 35/15025/25 ━━━━━━━━━━━━━━━━━━━━ 5s 189ms/step - cos: 0.7677 - loss: 6.3730 - mse: 0.1909 - val_cos: 0.7692 - val_loss: 6.3082 - val_mse: 0.1881Epoch 36/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 177ms/step - cos: 0.7677 - loss: 6.3429 - mse: 0.1880 - val_cos: 0.7681 - val_loss: 6.2834 - val_mse: 0.1878Epoch 37/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 179ms/step - cos: 0.7671 - loss: 6.2941 - mse: 0.1861 - val_cos: 0.7697 - val_loss: 6.2232 - val_mse: 0.1849Epoch 38/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 178ms/step - cos: 0.7670 - loss: 6.2765 - mse: 0.1862 - val_cos: 0.7684 - val_loss: 6.1971 - val_mse: 0.1828Epoch 39/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 179ms/step - cos: 0.7664 - loss: 6.2457 - mse: 0.1831 - val_cos: 0.7686 - val_loss: 6.1664 - val_mse: 0.1812Epoch 40/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 179ms/step - cos: 0.7698 - loss: 6.1896 - mse: 0.1797 - val_cos: 0.7696 - val_loss: 6.1331 - val_mse: 0.1777Epoch 41/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 178ms/step - cos: 0.7670 - loss: 6.1657 - mse: 0.1788 - val_cos: 0.7701 - val_loss: 6.1057 - val_mse: 0.1760Epoch 42/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 180ms/step - cos: 0.7690 - loss: 6.0656 - mse: 0.1760 - val_cos: 0.7693 - val_loss: 6.0554 - val_mse: 0.1738Epoch 43/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 178ms/step - cos: 0.7682 - loss: 6.0856 - mse: 0.1745 - val_cos: 0.7676 - val_loss: 6.0448 - val_mse: 0.1722Epoch 44/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 180ms/step - cos: 0.7665 - loss: 6.0528 - mse: 0.1724 - val_cos: 0.7683 - val_loss: 6.0189 - val_mse: 0.1710Epoch 45/15025/25 ━━━━━━━━━━━━━━━━━━━━ 5s 186ms/step - cos: 0.7691 - loss: 6.0253 - mse: 0.1699 - val_cos: 0.7685 - val_loss: 5.9979 - val_mse: 0.1665Epoch 46/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 179ms/step - cos: 0.7679 - loss: 5.9833 - mse: 0.1665 - val_cos: 0.7681 - val_loss: 5.9251 - val_mse: 0.1675Epoch 47/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 175ms/step - cos: 0.7680 - loss: 5.9603 - mse: 0.1664 - val_cos: 0.7698 - val_loss: 5.9433 - val_mse: 0.1651Epoch 48/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 182ms/step - cos: 0.7701 - loss: 5.9152 - mse: 0.1653 - val_cos: 0.7703 - val_loss: 5.9054 - val_mse: 0.1632Epoch 49/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 180ms/step - cos: 0.7682 - loss: 5.8829 - mse: 0.1632 - val_cos: 0.7692 - val_loss: 5.8782 - val_mse: 0.1611Epoch 50/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 182ms/step - cos: 0.7683 - loss: 5.8843 - mse: 0.1602 - val_cos: 0.7705 - val_loss: 5.8711 - val_mse: 0.1598Epoch 51/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 178ms/step - cos: 0.7687 - loss: 5.8453 - mse: 0.1596 - val_cos: 0.7680 - val_loss: 5.8498 - val_mse: 0.1603Epoch 52/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 179ms/step - cos: 0.7685 - loss: 5.8001 - mse: 0.1577 - val_cos: 0.7699 - val_loss: 5.7597 - val_mse: 0.1563Epoch 53/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 173ms/step - cos: 0.7685 - loss: 5.7991 - mse: 0.1569 - val_cos: 0.7682 - val_loss: 5.7875 - val_mse: 0.1550Epoch 54/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 176ms/step - cos: 0.7680 - loss: 5.7853 - mse: 0.1547 - val_cos: 0.7707 - val_loss: 5.7683 - val_mse: 0.1524Epoch 55/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 179ms/step - cos: 0.7691 - loss: 5.7863 - mse: 0.1526 - val_cos: 0.7705 - val_loss: 5.7501 - val_mse: 0.1514Epoch 56/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 179ms/step - cos: 0.7692 - loss: 5.7813 - mse: 0.1511 - val_cos: 0.7694 - val_loss: 5.7335 - val_mse: 0.1502Epoch 57/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 179ms/step - cos: 0.7699 - loss: 5.7194 - mse: 0.1498 - val_cos: 0.7694 - val_loss: 5.7055 - val_mse: 0.1492Epoch 58/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 181ms/step - cos: 0.7704 - loss: 5.6757 - mse: 0.1483 - val_cos: 0.7700 - val_loss: 5.6847 - val_mse: 0.1472Epoch 59/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 181ms/step - cos: 0.7690 - loss: 5.7145 - mse: 0.1485 - val_cos: 0.7699 - val_loss: 5.6508 - val_mse: 0.1456Epoch 60/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 180ms/step - cos: 0.7673 - loss: 5.6932 - mse: 0.1473 - val_cos: 0.7707 - val_loss: 5.6501 - val_mse: 0.1436Epoch 61/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 180ms/step - cos: 0.7694 - loss: 5.6243 - mse: 0.1447 - val_cos: 0.7689 - val_loss: 5.6231 - val_mse: 0.1428Epoch 62/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 180ms/step - cos: 0.7684 - loss: 5.6316 - mse: 0.1423 - val_cos: 0.7688 - val_loss: 5.5892 - val_mse: 0.1425Epoch 63/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 177ms/step - cos: 0.7677 - loss: 5.6548 - mse: 0.1434 - val_cos: 0.7710 - val_loss: 5.5681 - val_mse: 0.1399Epoch 64/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 174ms/step - cos: 0.7680 - loss: 5.6244 - mse: 0.1421 - val_cos: 0.7698 - val_loss: 5.5903 - val_mse: 0.1400Epoch 65/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 180ms/step - cos: 0.7681 - loss: 5.6289 - mse: 0.1406 - val_cos: 0.7687 - val_loss: 5.5534 - val_mse: 0.1409Epoch 66/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 177ms/step - cos: 0.7688 - loss: 5.5736 - mse: 0.1403 - val_cos: 0.7702 - val_loss: 5.5605 - val_mse: 0.1376Epoch 67/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 179ms/step - cos: 0.7700 - loss: 5.5189 - mse: 0.1380 - val_cos: 0.7702 - val_loss: 5.5123 - val_mse: 0.1363Epoch 68/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 175ms/step - cos: 0.7687 - loss: 5.5515 - mse: 0.1369 - val_cos: 0.7691 - val_loss: 5.5241 - val_mse: 0.1370Epoch 69/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 181ms/step - cos: 0.7702 - loss: 5.5545 - mse: 0.1357 - val_cos: 0.7699 - val_loss: 5.4955 - val_mse: 0.1362Epoch 70/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 179ms/step - cos: 0.7690 - loss: 5.4659 - mse: 0.1352 - val_cos: 0.7703 - val_loss: 5.4853 - val_mse: 0.1337Epoch 71/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 179ms/step - cos: 0.7681 - loss: 5.4991 - mse: 0.1344 - val_cos: 0.7683 - val_loss: 5.4826 - val_mse: 0.1333Epoch 72/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 177ms/step - cos: 0.7681 - loss: 5.4836 - mse: 0.1327 - val_cos: 0.7693 - val_loss: 5.4592 - val_mse: 0.1316Epoch 73/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 178ms/step - cos: 0.7702 - loss: 5.4963 - mse: 0.1315 - val_cos: 0.7706 - val_loss: 5.4468 - val_mse: 0.1308Epoch 74/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 178ms/step - cos: 0.7696 - loss: 5.3915 - mse: 0.1302 - val_cos: 0.7698 - val_loss: 5.4245 - val_mse: 0.1298Epoch 75/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 178ms/step - cos: 0.7706 - loss: 5.4288 - mse: 0.1288 - val_cos: 0.7695 - val_loss: 5.3944 - val_mse: 0.1290Epoch 76/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 180ms/step - cos: 0.7676 - loss: 5.4072 - mse: 0.1294 - val_cos: 0.7708 - val_loss: 5.3982 - val_mse: 0.1279Epoch 77/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 179ms/step - cos: 0.7688 - loss: 5.3941 - mse: 0.1292 - val_cos: 0.7698 - val_loss: 5.4304 - val_mse: 0.1282Epoch 78/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 179ms/step - cos: 0.7692 - loss: 5.4147 - mse: 0.1282 - val_cos: 0.7707 - val_loss: 5.3892 - val_mse: 0.1265Epoch 79/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 177ms/step - cos: 0.7703 - loss: 5.3819 - mse: 0.1260 - val_cos: 0.7696 - val_loss: 5.3757 - val_mse: 0.1265Epoch 80/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 181ms/step - cos: 0.7691 - loss: 5.3872 - mse: 0.1262 - val_cos: 0.7688 - val_loss: 5.3662 - val_mse: 0.1262Epoch 81/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 179ms/step - cos: 0.7701 - loss: 5.3129 - mse: 0.1245 - val_cos: 0.7701 - val_loss: 5.3568 - val_mse: 0.1245Epoch 82/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 182ms/step - cos: 0.7690 - loss: 5.3379 - mse: 0.1245 - val_cos: 0.7694 - val_loss: 5.3354 - val_mse: 0.1242Epoch 83/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 180ms/step - cos: 0.7687 - loss: 5.3438 - mse: 0.1245 - val_cos: 0.7719 - val_loss: 5.3168 - val_mse: 0.1228Epoch 84/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 182ms/step - cos: 0.7681 - loss: 5.3040 - mse: 0.1235 - val_cos: 0.7715 - val_loss: 5.3151 - val_mse: 0.1220Epoch 85/15025/25 ━━━━━━━━━━━━━━━━━━━━ 5s 183ms/step - cos: 0.7685 - loss: 5.3504 - mse: 0.1237 - val_cos: 0.7695 - val_loss: 5.3025 - val_mse: 0.1231Epoch 86/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 174ms/step - cos: 0.7685 - loss: 5.3010 - mse: 0.1224 - val_cos: 0.7705 - val_loss: 5.3040 - val_mse: 0.1212Epoch 87/15025/25 ━━━━━━━━━━━━━━━━━━━━ 5s 183ms/step - cos: 0.7702 - loss: 5.2738 - mse: 0.1207 - val_cos: 0.7702 - val_loss: 5.2965 - val_mse: 0.1218Epoch 88/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 180ms/step - cos: 0.7689 - loss: 5.2917 - mse: 0.1206 - val_cos: 0.7699 - val_loss: 5.2888 - val_mse: 0.1208Epoch 89/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 180ms/step - cos: 0.7696 - loss: 5.3199 - mse: 0.1208 - val_cos: 0.7689 - val_loss: 5.2589 - val_mse: 0.1208Epoch 90/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 179ms/step - cos: 0.7682 - loss: 5.2979 - mse: 0.1212 - val_cos: 0.7711 - val_loss: 5.2490 - val_mse: 0.1197Epoch 91/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 174ms/step - cos: 0.7701 - loss: 5.2316 - mse: 0.1198 - val_cos: 0.7712 - val_loss: 5.2642 - val_mse: 0.1194Epoch 92/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 182ms/step - cos: 0.7691 - loss: 5.2812 - mse: 0.1199 - val_cos: 0.7704 - val_loss: 5.2346 - val_mse: 0.1190Epoch 93/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 175ms/step - cos: 0.7688 - loss: 5.2679 - mse: 0.1191 - val_cos: 0.7693 - val_loss: 5.2493 - val_mse: 0.1184Epoch 94/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 179ms/step - cos: 0.7690 - loss: 5.2947 - mse: 0.1185 - val_cos: 0.7703 - val_loss: 5.2468 - val_mse: 0.1179Epoch 95/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 181ms/step - cos: 0.7697 - loss: 5.2224 - mse: 0.1174 - val_cos: 0.7699 - val_loss: 5.2175 - val_mse: 0.1174Epoch 96/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 180ms/step - cos: 0.7679 - loss: 5.2491 - mse: 0.1178 - val_cos: 0.7706 - val_loss: 5.2031 - val_mse: 0.1174Epoch 97/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 176ms/step - cos: 0.7704 - loss: 5.2146 - mse: 0.1168 - val_cos: 0.7690 - val_loss: 5.1959 - val_mse: 0.1174Epoch 98/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 178ms/step - cos: 0.7698 - loss: 5.1986 - mse: 0.1171 - val_cos: 0.7694 - val_loss: 5.1951 - val_mse: 0.1169Epoch 99/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 175ms/step - cos: 0.7685 - loss: 5.1510 - mse: 0.1173 - val_cos: 0.7692 - val_loss: 5.2092 - val_mse: 0.1164Epoch 100/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 174ms/step - cos: 0.7700 - loss: 5.1515 - mse: 0.1160 - val_cos: 0.7696 - val_loss: 5.2035 - val_mse: 0.1160Epoch 101/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 181ms/step - cos: 0.7685 - loss: 5.2375 - mse: 0.1161 - val_cos: 0.7713 - val_loss: 5.1944 - val_mse: 0.1159Epoch 102/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 175ms/step - cos: 0.7689 - loss: 5.1949 - mse: 0.1157 - val_cos: 0.7705 - val_loss: 5.1947 - val_mse: 0.1150Epoch 103/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 181ms/step - cos: 0.7692 - loss: 5.1795 - mse: 0.1150 - val_cos: 0.7703 - val_loss: 5.1872 - val_mse: 0.1147Epoch 104/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 179ms/step - cos: 0.7689 - loss: 5.1701 - mse: 0.1155 - val_cos: 0.7706 - val_loss: 5.1679 - val_mse: 0.1149Epoch 105/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 173ms/step - cos: 0.7685 - loss: 5.1989 - mse: 0.1154 - val_cos: 0.7689 - val_loss: 5.1848 - val_mse: 0.1153Epoch 106/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 182ms/step - cos: 0.7691 - loss: 5.1822 - mse: 0.1145 - val_cos: 0.7703 - val_loss: 5.1448 - val_mse: 0.1142Epoch 107/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 175ms/step - cos: 0.7695 - loss: 5.1392 - mse: 0.1146 - val_cos: 0.7708 - val_loss: 5.1465 - val_mse: 0.1139Epoch 108/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 177ms/step - cos: 0.7692 - loss: 5.2153 - mse: 0.1145 - val_cos: 0.7705 - val_loss: 5.1640 - val_mse: 0.1136Epoch 109/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 176ms/step - cos: 0.7690 - loss: 5.1583 - mse: 0.1140 - val_cos: 0.7689 - val_loss: 5.1519 - val_mse: 0.1142Epoch 110/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 178ms/step - cos: 0.7700 - loss: 5.1384 - mse: 0.1134 - val_cos: 0.7688 - val_loss: 5.1593 - val_mse: 0.1139Epoch 111/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 180ms/step - cos: 0.7695 - loss: 5.1484 - mse: 0.1134 - val_cos: 0.7709 - val_loss: 5.1299 - val_mse: 0.1132Epoch 112/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 181ms/step - cos: 0.7699 - loss: 5.1683 - mse: 0.1126 - val_cos: 0.7698 - val_loss: 5.1275 - val_mse: 0.1131Epoch 113/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 171ms/step - cos: 0.7694 - loss: 5.1230 - mse: 0.1123 - val_cos: 0.7703 - val_loss: 5.1364 - val_mse: 0.1121Epoch 114/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 178ms/step - cos: 0.7699 - loss: 5.1434 - mse: 0.1129 - val_cos: 0.7691 - val_loss: 5.1523 - val_mse: 0.1132Epoch 115/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 178ms/step - cos: 0.7686 - loss: 5.1086 - mse: 0.1123 - val_cos: 0.7695 - val_loss: 5.1388 - val_mse: 0.1123Epoch 116/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 177ms/step - cos: 0.7700 - loss: 5.1089 - mse: 0.1121 - val_cos: 0.7698 - val_loss: 5.1056 - val_mse: 0.1125Epoch 117/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 176ms/step - cos: 0.7708 - loss: 5.0898 - mse: 0.1122 - val_cos: 0.7715 - val_loss: 5.1041 - val_mse: 0.1120Epoch 118/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 174ms/step - cos: 0.7688 - loss: 5.1048 - mse: 0.1123 - val_cos: 0.7698 - val_loss: 5.1103 - val_mse: 0.1117Epoch 119/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 177ms/step - cos: 0.7690 - loss: 5.1339 - mse: 0.1123 - val_cos: 0.7707 - val_loss: 5.0992 - val_mse: 0.1114Epoch 120/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 174ms/step - cos: 0.7707 - loss: 5.0996 - mse: 0.1114 - val_cos: 0.7691 - val_loss: 5.1405 - val_mse: 0.1121Epoch 121/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 176ms/step - cos: 0.7706 - loss: 5.0921 - mse: 0.1117 - val_cos: 0.7705 - val_loss: 5.1123 - val_mse: 0.1117Epoch 122/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 175ms/step - cos: 0.7694 - loss: 5.1215 - mse: 0.1118 - val_cos: 0.7730 - val_loss: 5.1020 - val_mse: 0.1101Epoch 123/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 173ms/step - cos: 0.7694 - loss: 5.1185 - mse: 0.1113 - val_cos: 0.7713 - val_loss: 5.1067 - val_mse: 0.1113Epoch 124/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 175ms/step - cos: 0.7676 - loss: 5.1077 - mse: 0.1121 - val_cos: 0.7699 - val_loss: 5.1011 - val_mse: 0.1119Epoch 125/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 178ms/step - cos: 0.7692 - loss: 5.1002 - mse: 0.1116 - val_cos: 0.7722 - val_loss: 5.0920 - val_mse: 0.1106Epoch 126/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 179ms/step - cos: 0.7700 - loss: 5.0861 - mse: 0.1109 - val_cos: 0.7708 - val_loss: 5.0755 - val_mse: 0.1110Epoch 127/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 176ms/step - cos: 0.7687 - loss: 5.1179 - mse: 0.1116 - val_cos: 0.7701 - val_loss: 5.0813 - val_mse: 0.1113Epoch 128/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 176ms/step - cos: 0.7691 - loss: 5.0677 - mse: 0.1114 - val_cos: 0.7712 - val_loss: 5.0920 - val_mse: 0.1111Epoch 129/15025/25 ━━━━━━━━━━━━━━━━━━━━ 5s 182ms/step - cos: 0.7693 - loss: 5.0750 - mse: 0.1109 - val_cos: 0.7697 - val_loss: 5.1003 - val_mse: 0.1117Epoch 130/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 180ms/step - cos: 0.7696 - loss: 5.1088 - mse: 0.1111 - val_cos: 0.7700 - val_loss: 5.1090 - val_mse: 0.1112Epoch 131/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 180ms/step - cos: 0.7710 - loss: 5.0843 - mse: 0.1103 - val_cos: 0.7703 - val_loss: 5.0754 - val_mse: 0.1116Epoch 132/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 178ms/step - cos: 0.7694 - loss: 5.0816 - mse: 0.1113 - val_cos: 0.7695 - val_loss: 5.0800 - val_mse: 0.1109Epoch 133/15025/25 ━━━━━━━━━━━━━━━━━━━━ 5s 183ms/step - cos: 0.7690 - loss: 5.0900 - mse: 0.1110 - val_cos: 0.7691 - val_loss: 5.1067 - val_mse: 0.1107Epoch 134/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 179ms/step - cos: 0.7687 - loss: 5.1286 - mse: 0.1116 - val_cos: 0.7706 - val_loss: 5.0937 - val_mse: 0.1104Epoch 135/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 179ms/step - cos: 0.7699 - loss: 5.0638 - mse: 0.1106 - val_cos: 0.7692 - val_loss: 5.1000 - val_mse: 0.1115Epoch 136/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 178ms/step - cos: 0.7696 - loss: 5.0928 - mse: 0.1109 - val_cos: 0.7711 - val_loss: 5.1196 - val_mse: 0.1105Epoch 137/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 178ms/step - cos: 0.7688 - loss: 5.0861 - mse: 0.1113 - val_cos: 0.7689 - val_loss: 5.0883 - val_mse: 0.1112Epoch 138/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 182ms/step - cos: 0.7705 - loss: 5.0776 - mse: 0.1104 - val_cos: 0.7706 - val_loss: 5.0706 - val_mse: 0.1108Epoch 139/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 180ms/step - cos: 0.7708 - loss: 5.0805 - mse: 0.1106 - val_cos: 0.7694 - val_loss: 5.0848 - val_mse: 0.1114Epoch 140/15025/25 ━━━━━━━━━━━━━━━━━━━━ 5s 183ms/step - cos: 0.7709 - loss: 5.0705 - mse: 0.1100 - val_cos: 0.7696 - val_loss: 5.1025 - val_mse: 0.1108Epoch 141/15025/25 ━━━━━━━━━━━━━━━━━━━━ 5s 184ms/step - cos: 0.7689 - loss: 5.0755 - mse: 0.1111 - val_cos: 0.7695 - val_loss: 5.0697 - val_mse: 0.1109Epoch 142/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 176ms/step - cos: 0.7693 - loss: 5.0860 - mse: 0.1110 - val_cos: 0.7698 - val_loss: 5.0901 - val_mse: 0.1108Epoch 143/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 182ms/step - cos: 0.7703 - loss: 5.0945 - mse: 0.1105 - val_cos: 0.7703 - val_loss: 5.0849 - val_mse: 0.1110Epoch 144/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 181ms/step - cos: 0.7682 - loss: 5.0852 - mse: 0.1109 - val_cos: 0.7705 - val_loss: 5.0823 - val_mse: 0.1107Epoch 145/15025/25 ━━━━━━━━━━━━━━━━━━━━ 5s 183ms/step - cos: 0.7700 - loss: 5.0820 - mse: 0.1099 - val_cos: 0.7691 - val_loss: 5.0824 - val_mse: 0.1114Epoch 146/15025/25 ━━━━━━━━━━━━━━━━━━━━ 5s 184ms/step - cos: 0.7698 - loss: 5.1090 - mse: 0.1105 - val_cos: 0.7697 - val_loss: 5.0849 - val_mse: 0.1113Epoch 147/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 177ms/step - cos: 0.7699 - loss: 5.0637 - mse: 0.1106 - val_cos: 0.7702 - val_loss: 5.0996 - val_mse: 0.1107Epoch 148/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 179ms/step - cos: 0.7708 - loss: 5.0515 - mse: 0.1101 - val_cos: 0.7695 - val_loss: 5.0811 - val_mse: 0.1111Epoch 149/15025/25 ━━━━━━━━━━━━━━━━━━━━ 5s 192ms/step - cos: 0.7692 - loss: 5.0959 - mse: 0.1111 - val_cos: 0.7705 - val_loss: 5.1056 - val_mse: 0.1106Epoch 150/15025/25 ━━━━━━━━━━━━━━━━━━━━ 4s 178ms/step - cos: 0.7685 - loss: 5.1008 - mse: 0.1110 - val_cos: 0.7713 - val_loss: 5.0885 - val_mse: 0.1105Visualize training history
Section titled “Visualize training history”Let’s visualize the training history to understand the model’s performance during training. This will help to ensure the model is learning and not under or overfitting.
fig, _ = helia.plotting.plot_history_metrics( history.history, metrics=["loss", "cos"], title="Training History", colors=[plot_theme.primary_color, plot_theme.secondary_color], stack=True, figsize=(9, 5),)fig.tight_layout()fig.show()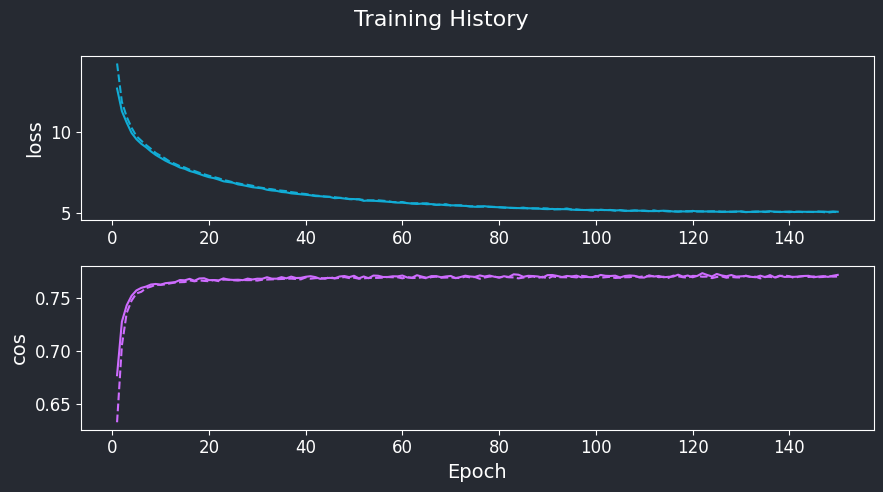
Model evaluation
Section titled “Model evaluation”Now that we have trained the model, we will evaluate the model on the test dataset. The model’s built-in evaluate method will be used to calculate the loss and metrics on the dataset.
# Convert validation dataset to numpy arraystest_x1, test_x2 = [], []for inputs in val_ds.as_numpy_iterator(): test_x1.append(inputs[helia.trainers.SimCLRTrainer.AUG_SAMPLES_0]) test_x2.append(inputs[helia.trainers.SimCLRTrainer.AUG_SAMPLES_1])test_x1 = np.concatenate(test_x1)test_x2 = np.concatenate(test_x2)test_y1 = encoder.predict(test_x1)test_y2 = encoder.predict(test_x2)288/288 ━━━━━━━━━━━━━━━━━━━━ 1s 923us/step288/288 ━━━━━━━━━━━━━━━━━━━━ 0s 1ms/steprst = helia.metrics.compute_metrics(metrics, test_y1, test_y2)logger.info("[VAL SET] " + ", ".join([f"{k.upper()}={v:.4f}" for k, v in rst.items()]))INFO [VAL SET] MSE=0.0132, COS=0.9683 4122487501.py:2Export model to TF Lite / TFLM
Section titled “Export model to TF Lite / TFLM”Once we have trained and evaluated the model, we need to export the model into a format that can be used for inference on the edge. Currently, we export the model to TensorFlow Lite flatbuffer format. This will also generate a C header file that can be used with TensorFlow Lite for Microcontrollers (TFLM).
For this model, we will export as a 32-bit floating point model.
NOTE: We utilize CONCRETE mode to lower the model to concrete functions before converting. This is because TF (MLIR) fails to properly lower the dilated convolutional layers.
converter = helia.converters.tflite.TfLiteKerasConverter(model=encoder)
# Redirect stdout and stderr to devnull since TFLite converter is very verbosewith open(os.devnull, "w") as devnull:    with contextlib.redirect_stdout(devnull), contextlib.redirect_stderr(devnull):        tflite_content = converter.convert(            test_x=test_x1, quantization="FP32", io_type="float32", mode="KERAS", strict=False, verbose=verbose        )
W0000 00:00:1723835186.987318 712291 tf_tfl_flatbuffer_helpers.cc:392] Ignored output_format.W0000 00:00:1723835186.987329 712291 tf_tfl_flatbuffer_helpers.cc:395] Ignored drop_control_dependency.Save TFLite model as both a file and C header
Section titled “Save TFLite model as both a file and C header”converter.export(tflite_path=job_dir / "model.tflite")
converter.export_header( header_path=job_dir / "model.h", name="model",)Evaluate TFLite model against TensorFlow model
Section titled “Evaluate TFLite model against TensorFlow model”We will instantiate a tflite interpreter and evaluate the model on the test dataset. This will help us ensure that the model has been exported correctly and is ready for deployment.
tflite = helia.interpreters.tflite.TfLiteKerasInterpreter(tflite_content)tflite.compile()INFO: Created TensorFlow Lite XNNPACK delegate for CPU.converter = helia.converters.tflite.TfLiteKerasConverter(model=encoder)
tflite_content = converter.convert( test_x=test_x1, quantization="FP32", io_type="float32", mode="KERAS", strict=False, verbose=verbose)Saved output
Saved artifact at '/tmp/tmpserse9cu'. The following endpoints are available:
* Endpoint 'serve'  args_0 (POSITIONAL_ONLY): TensorSpec(shape=(None, 800, 1), dtype=tf.float32, name='input')Output Type:  TensorSpec(shape=(None, 128), dtype=tf.float32, name=None)Captures:  132164125518800: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164125517648: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164125516880: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164125517840: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164125518032: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164125516688: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164116070672: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164116079888: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164125515920: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164125516112: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164109445904: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164109445328: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164109443024: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164109440912: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164109448976: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164109449168: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164109448784: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164109449552: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164109450320: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164109450128: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120085136: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120084752: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164109449936: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120085904: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120086096: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120084560: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120087056: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120086480: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120088016: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120088592: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120089360: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120087440: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120088976: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120089744: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120091856: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120092624: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120091664: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120091472: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120092816: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120090512: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120093776: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120093200: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120094160: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120094928: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120096080: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120094544: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120095312: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120096272: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120097232: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120098000: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120093584: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120096656: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120098192: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120097040: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120099152: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120098576: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120099536: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120100688: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120740496: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120098960: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120100304: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120740304: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120742032: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120742800: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120741840: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120741648: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120742992: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120741456: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120743952: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120743376: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120744336: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120745104: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120746256: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120744720: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120745488: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120746448: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120747408: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120748176: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120743760: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120746832: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120748368: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120747216: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120749328: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120748752: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120749712: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120750480: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120751632: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120750096: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120750864: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120751056: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120753168: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120753936: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120752976: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120752784: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120754128: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120752592: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120755088: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120754896: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120755472: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164117676304: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164117676112: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164120756048: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164117677264: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164117677456: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164117678416: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164117679184: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164117676496: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164117677840: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164117679376: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164117678224: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164117680336: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164117679760: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164117680720: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164117681488: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164117682640: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164117681104: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164117681872: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164117682832: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164117683792: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164117684560: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164117680144: TensorSpec(shape=(), dtype=tf.resource, name=None)  132164117683216: TensorSpec(shape=(), dtype=tf.resource, name=None)
W0000 00:00:1723835188.716817 712291 tf_tfl_flatbuffer_helpers.cc:392] Ignored output_format.W0000 00:00:1723835188.716827 712291 tf_tfl_flatbuffer_helpers.cc:395] Ignored drop_control_dependency.tflite = helia.interpreters.tflite.TfLiteKerasInterpreter(tflite_content)tflite.compile()y1_pred_tf = encoder.predict(test_x1)y2_pred_tf = encoder.predict(test_x2)
y1_pred_tfl = tflite.predict(x=test_x1)y2_pred_tfl = tflite.predict(x=test_x2) 1/288 ━━━━━━━━━━━━━━━━━━━━ 2s 9ms/step288/288 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step288/288 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/steptf_rst = helia.metrics.compute_metrics(metrics, y1_pred_tf, y2_pred_tf)tfl_rst = helia.metrics.compute_metrics(metrics, y1_pred_tfl, y2_pred_tfl)logger.info("[TF METRICS] " + " ".join([f"{k.upper()}={v:.4f}" for k, v in tf_rst.items()]))logger.info("[TFL METRICS] " + " ".join([f"{k.upper()}={v:.4f}" for k, v in tfl_rst.items()]))INFO [TF METRICS] MSE=0.0132 COS=0.9683 2850812944.py:3INFO [TFL METRICS] MSE=0.0132 COS=0.9683 2850812944.py:4ECG Foundation Demo
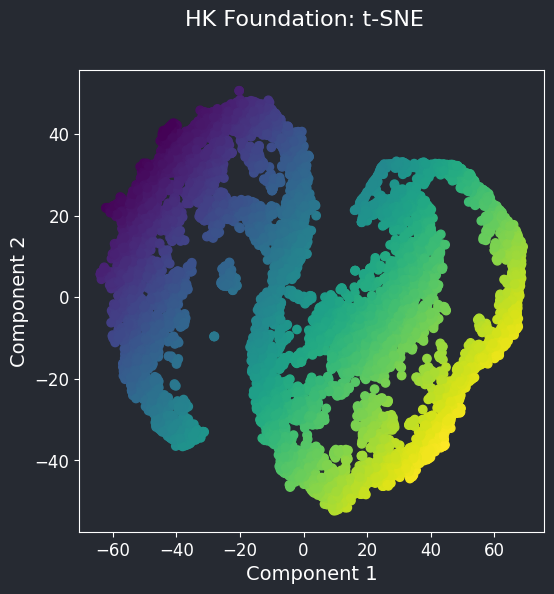
Section titled “ECG Foundation Demo”Finally, we will showcase the foundation model by running across lots of patients and plotting via t-SNE to view the embeddings. This will help us understand how the model is clustering the data and if it is learning useful features.
# Compute t-SNElogger.debug("Computing t-SNE")tsne = TSNE(n_components=2, random_state=0, n_iter=1000, perplexity=75)x_tsne = tsne.fit_transform(test_y1)
# Plot t-SNE in matplotlibfig, ax = plt.subplots(1, 1, figsize=(6, 6))ax.scatter(x_tsne[:, 0], x_tsne[:, 1], c=x_tsne[:, 0] - x_tsne[:, 1], cmap="viridis")fig.suptitle("HK Foundation: t-SNE")ax.set_xlabel("Component 1")ax.set_ylabel("Component 2")fig.show()